برنامهنویسی در فضای وزن؛ وقتی مدلهای زبانی بزرگ مستقیماً وزنهای شبکههای عصبی را میخوانند و اصلاح میکنند — Astra can read and write weights to improve Qwen
خلاصه
مقاله جدیدی نشان میدهد مدلهای زبانی پیشرو میتوانند بدون استفاده از گرادیان یا بازخورد محیطی، وزنهای خام شبکههای عصبی را بخوانند، تحلیل کنند و تغییر دهند. این رویکرد که «برنامهنویسی در فضای وزن» نامیده میشود، قادر است خطاهای مدلهایی مثل Qwen را با تغییر جزئی وزنها به شدت بهبود بخشد.
مقدمه
در تاریخ یادگیری عمیق، ما همیشه برای بهینهسازی شبکههای عصبی به بهینهسازهای نمادین و سادهای مثل Adam یا Muon متکی بودهایم؛ ابزارهایی مبتنی بر گرادیان که وزنها را تغییر میدهند. اما مقاله جدیدی با عنوان «Sparks of Weight-Space Programming» نشان میدهد که مدلهای زبانی بزرگ (LLM) پیشرو میتوانند به طور بومی وزنهای شبکه عصبی را بخوانند، ساختار هندسی آنها را درک کنند و بدون اجرای حلقههای آموزشی سنتی، آنها را بازنویسی کنند. به این پارادایم جدید، برنامهنویسی در فضای وزن (Weight-Space Programming) گفته میشود.
جزئیات فنی و آزمایشها
این پژوهش نشان میدهد که هوش مصنوعی میتواند کارهایی فراتر از حد انتظار انسان روی فضای پیوسته وزنها انجام دهد. برخی از آزمایشهای کلیدی انجام شده عبارتند از:
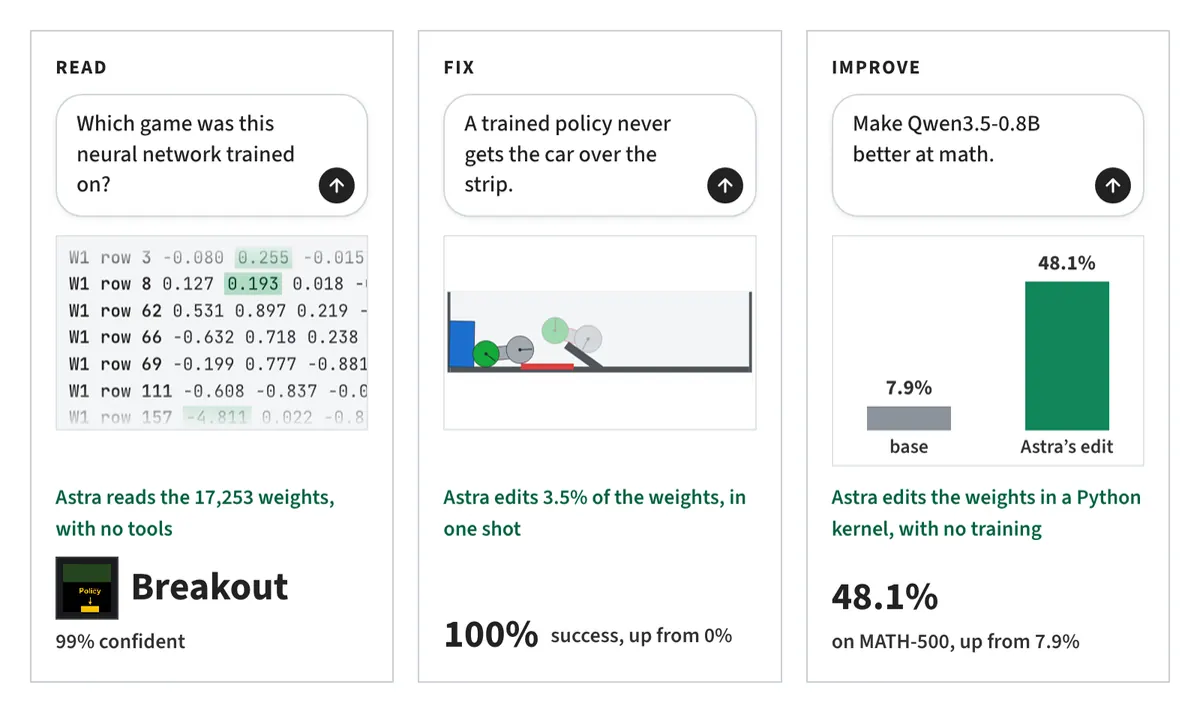
- خواندن وزنها: مدل GPT-6 Astra توانست بدون هیچگونه دسترسی به ورودی یا خروجی و صرفاً با بررسی مقادیر عددی وزنها، تشخیص دهد که شبکههای عصبی مختلف برای چه بازیهایی (مانند Pac-Man یا Breakout) یا مدلهای انتشار (Diffusion Models) برای چه اشکالی آموزش دیدهاند.
- تحلیل لایههای میانی: حتی وقتی لایههای ورودی و خروجی مدلهای زبانی کوچک حذف شد، Astra توانست با بررسی فقط چهار بلوک ترنسفورمر میانی، زبان آموزشدیده (مانند پایتون یا ژاپنی) را شناسایی کند و سرهای توجه (Attention Heads) مربوط به کپی کردن متن را دقیقاً پیدا کند.
- اصلاح مدلهای بزرگ: یکی از شگفتانگیزترین بخشها، اعمال تغییرات روی مدل
Qwen3.5-0.8Bبود. Astra با شناسایی یک مشکل ساختاری در وزنها که باعث ایجاد حلقههای استدلالی معیوب میشد، توانست تنها با ویرایش ۰.۰۱۶ درصد از وزنها، عملکرد مدل را در بنچمارک MATH-500 به شکل چشمگیری افزایش دهد و مهارت دستورپذیری (IFEval) آن را نیز چند برابر کند.
چرا این موضوع برای مهندسان اهمیت دارد؟
این پژوهش نگاه ما را به مدلسازی و بهینهسازی تغییر میدهد. به جای اتکای صرف به گرادیان نزولی و دادههای انبوه، اکنون این احتمال وجود دارد که هوش مصنوعی بتواند با استدلال معنایی درباره وزنها، مدلهای دیگر را بهینه یا حتی از صفر طراحی کند. این رویکرد میتواند تحولی بزرگ در حوزههایی نظیر تفسیرپذیری مدلها (Interpretability) و روشهای خودبهینهسازی (RSI) ایجاد کند.
دیدگاه جامعه توسعهدهندگان در Hacker News
بحثهای داغی پیرامون این مقاله در هکرنیوز شکل گرفت. کاربران از اینکه یک مدل زبانی میتواند مستقیماً مثل یک جراح درون وزنهای یک مدل دیگر (مانند Qwen) دست ببرد و آن را بهبود ببخشد، به شدت شگفتزده شده بودند. برخی مهندسان اشاره کردند که این قابلیت احتمالاً حاصل تمرینهای مدل برای بهبود خودکار (Self-Improvement) است و ابراز نگرانی کردند که با اعمال محدودیتهای امنیتی شدیدتر توسط شرکتها، دسترسی به چنین قابلیتهایی بهزودی محدود شود.
این مطلب بهصورت کاملاً خودکار و با هوش مصنوعی از مقالهٔ اصلی و بحث هکرنیوز تهیه شده و ممکن است خطا داشته باشد. حقوق مطلب اصلی متعلق به نویسندهٔ آن است. قوانین و گزارش مشکل