آموزش یک مدل هوش مصنوعی ۳۶۰ میلیون پارامتری برای شبیهسازی ترمینال لینوکس — WorldTUI: I trained a 360M model to pretend to be a terminal
خلاصه
یک توسعهدهنده با استفاده از Fine-tune کردن مدل Qwen2.5-Coder، مدل زبانی کوچکی ساخته است که بدون داشتن سیستمعامل واقعی، رفتار یک ترمینال را شبیهسازی میکند. این پروژه نشان میدهد چگونه میتوان با بهینهسازی واژگان، پردازش موازی ردیفها و تکنیکهای رمزگشایی، مدلهای هوش مصنوعی را در مرورگر و با WebGPU اجرا کرد.
معرفی پروژه WorldTUI
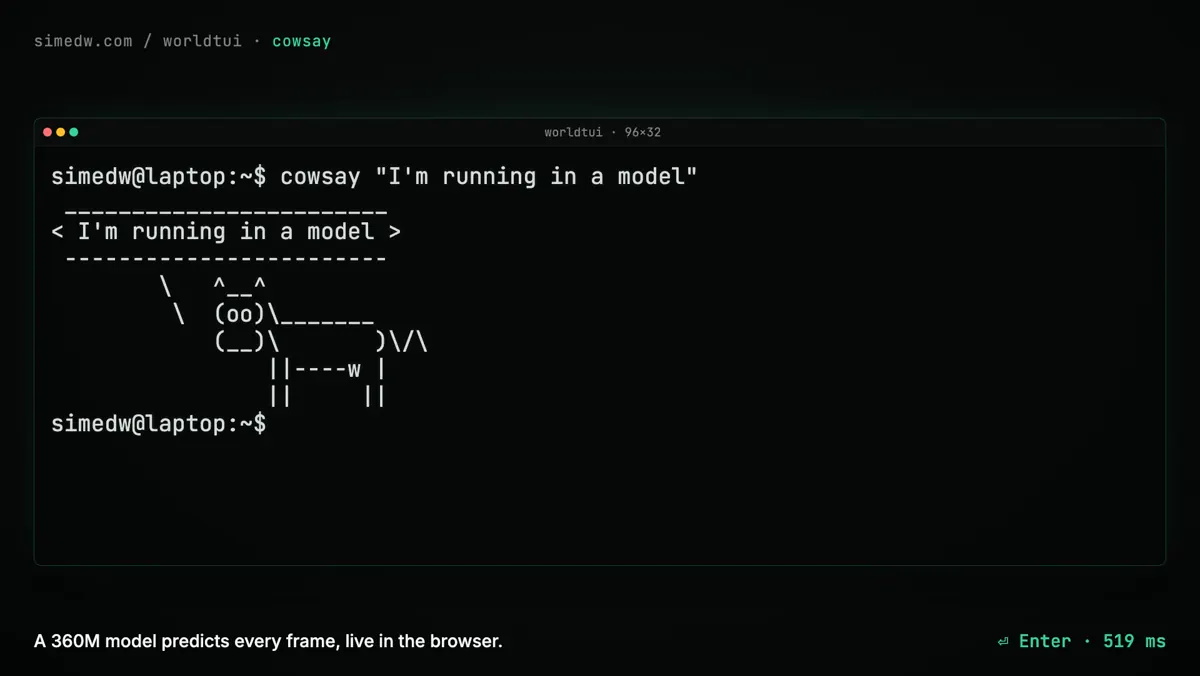
ایده مدلهای جهانی (World Models) که به جای موتورهای سنتی رندر، فریم بعدی را بر اساس ورودی کاربر پیشبینی میکنند، در حال گسترش است. پروژهای به نام WorldTUI این ایده را به جای دنیای گرافیکی، در محیط ترمینال پیادهسازی کرده است. در این پروژه هیچ شل، فایلسیستم یا سیستمعامل واقعی پشت صحنه وجود ندارد؛ با هر فشردن کلید، مدل پیشبینی میکند که صفحه نمایش چطور تغییر کند.
این مدل میتواند فایل بسازد، ابزارهایی مانند vim و tmux را اجرا کند، بازی Snake را بالا بیاورد و حتی تا چند فرمان قبلی را به خاطر بسپارد. نسخه نمایشی این پروژه با حجم تنها ۲۰۸ مگابایت روی مرورگر و با کمک WebGPU اجرا میشود.
جزئیات فنی و معماری
ایده اصلی این است که ترمینال به عنوان یک شبکه دوبعدی از کاراکترها در نظر گرفته شود. به جای پیشبینی جریان متون، مدل تغییرات صفحه و جایگاه مکاننما (Cursor) را پیشبینی میکند.
- واژگان کوچک (Vocabulary Reduction): مدل پایه از یک واژگان عظیم ۱۵۱ هزار توکنی استفاده میکرد. توسعهدهنده با محدود کردن آن به ۳۳۳ توکن شامل بایتها، مختصات ردیفها و چند عملگر خاص، حجم مدل را کاهش داد.
- عملیات کپی ردیفها: برای جلوگیری از تولید هزاران توکن هنگام اسکرول صفحه، از دستور
COPYاستفاده شده است که ردیفهای قبلی را جابهجا میکند. - تولید موازی ردیفها (Parallel Rows): از آنجا که بیشتر ردیفهای یک فریم به هم وابسته نیستند، مدل هر ردیف را به صورت موازی تولید میکند تا تاخیر (Latency) به شدت کاهش یابد.
- رمزگشایی حدسی (Speculative Decoding): برای جلوگیری از تداخل ردیفهای مستقل، خروجی موازی به عنوان پیشنویس استفاده شده و سپس توسط خود مدل به صورت ترتیبی اعتبارسنجی میشود.
تولید دادههای آموزشی و یادگیری از خطاها
دادههای آموزشی با اجرای برنامههای واقعی درون کانتینرهای Docker، شبیهسازی دستورات انسان (مانند خطاهای تایپی و تکمیل خودکار با Tab) و ثبت دقیق رویدادها تولید شدند. در مجموع ۳۳۶ هزار اپیزود معادل ۲ میلیارد توکن جمعآوری شد.
برای جلوگیری از انباشت خطاها در طول جلسات طولانی، از تکنیک الهامگرفته از DAgger استفاده شد. مدل یاد گرفت که چگونه اشتباهات خود (مانند غلط املایی در نام فایلها) را در مراحل بعدی اصلاح کند. این آموزش روی یک کارت گرافیک RTX 4090 انجام شد و در نهایت مدل بهینهشده با کمسازی (Quantization) به صورت int4 در آمد.
نگاه جامعه برنامهنویسان در هکرنیوز
کاربران Hacker News به شباهت این پروژه با تلاشهای مایکروسافت در شبیهسازی بازیها با هوش مصنوعی (مانند شبیهسازی Quake II) اشاره کردند. برخی نیز پیشنهاد کردند که قرار دادن چنین مدلهایی در اینترنت و بررسی تعامل رباتهای اسکرپر با آنها میتواند بسیار جذاب باشد. برای مهندسان نرمافزار، این پروژه نمونهای عالی از کاربرد Fine-tune دقیق، بهینهسازی توکنها و اجرای محلی مدلهای زبانی کوچک در سمت کلاینت است.
این مطلب بهصورت کاملاً خودکار و با هوش مصنوعی از مقالهٔ اصلی و بحث هکرنیوز تهیه شده و ممکن است خطا داشته باشد. حقوق مطلب اصلی متعلق به نویسندهٔ آن است. قوانین و گزارش مشکل