چرا رمزگشایی حدسی (Speculative Decoding) واقعاً سریع است؟ نگاهی به درون عملکرد GPU — Why Is Speculative Decoding Fast?
خلاصه
بر خلاف تصور رایج، رمزگشایی حدسی تعداد عملیات شناور (FLOPs) کمتری مصرف نمیکند؛ بلکه نوع کار پردازنده گرافیکی را از محدودیت حافظه به محدودیت پردازش تغییر میدهد. در این مقاله فنی بررسی میکنیم که چگونه این تکنیک در بچسایزهای کوچک سرعت تولید توکن در مدلهای زبان بزرگ را افزایش میدهد.
مقدمه ای بر رمزگشایی حدسی
بسیاری از مهندسان نرمافزار و توسعهدهندگان هوش مصنوعی بر این باورند که تکنیک Speculative Decoding به این دلیل سریعتر کار میکند که کار کمتری انجام میدهد؛ یعنی تصور میشود «اعتبارسنجی» یک توکن پیشنهادی به محاسبات یا همان FLOPs کمتری نسبت به تولید مستقیم آن نیاز دارد. اما واقعیت این است که در رمزگشایی حدسی، کل عملیات ممیز شناور انجامشده برای یک دنباله در واقع افزایش پیدا میکند.
پس راز سرعت آن در چیست؟ پاسخ در نوع کاری است که پردازنده گرافیکی (GPU) شما انجام میدهد.
تفاوت عملیات محدود به حافظه و محدود به پردازش
هنگامی که یک مدل زبان بزرگ (LLM) به صورت سنتی توکنها را یکییکی تولید میکند، سیستم با یک چالش جدی روبهروست:
- محدود به حافظه (Memory Bound): در حالت تولید توکن تکتک، برای هر توکن باید تمام پارامترهای فعال مدل (مثلاً مدلهایی با دهها میلیارد پارامتر) از حافظه جهانی به حافظه محلی منتقل شوند. در این حالت، GPU بخش زیادی از زمان خود را صرف انتظار برای بارگذاری دادهها میکند و بخش بزرگی از توان محاسباتی آن هدر میرود.
- محدود به پردازش (Compute Bound): زمانی که مدل تعداد زیادی توکن را به صورت موازی پردازش میکند، تمام بخشهای سختافزاری مشغول انجام محاسبات ماتریسی میشوند.
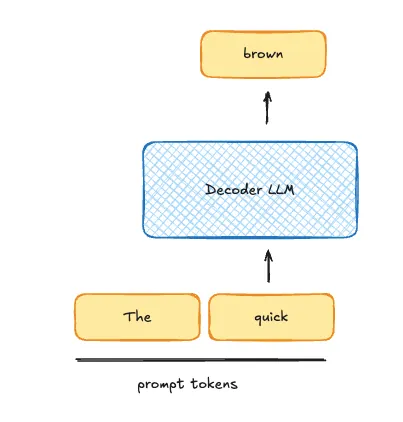
رمزگشایی حدسی در واقع تکنیکی است که با استفاده از یک مدل پیشنویس کوچک، توکنها را حدس زده و مدل بزرگتر آنها را به صورت موازی (در یک Pass) اعتبارسنجی میکند. این کار به GPU اجازه میدهد تا از توان پردازشی خالی و اصطلاحاً «رایگان» خود در بچسایزهای پایین نهایت استفاده را ببرد.
مبادله عرض با عمق (Breadth vs Depth)
فرض کنید تعداد بهینه توکن برای یک پردازش موازی مشخص است. اگر کمتر از آن را اجرا کنیم با محدودیت حافظه مواجهیم و اگر بیشتر باشد با محدودیت پردازش. ما دو راه پیش رو داریم:
- عرض (Breadth): اجرای چندین دنباله مختلف به صورت موازی که هر کدام یک توکن جلو میروند.
- عمق (Depth): استفاده از رمزگشایی حدسی برای جلو بردن عمیق یک دنباله منفرد با تولید چندین توکن در یک مرحله.
در هر دو حالت، GPU حجم کار تقریبا مشابهی انجام میدهد، اما در روش دوم پیشرفت بسیار بیشتری روی یک دنباله حاصل میشود. در بچسایزهای کوچک که از ظرفیت پردازشی کل GPU استفاده نمیشود، این روش بسیار کارآمد است.
چرا این موضوع برای مهندسان اهمیت دارد؟
شاید این مباحث تئوریک به نظر برسد، اما در پیادهسازی سرویسهای واقعی (Production) اهمیت سرنوشتسازی دارد:
- بار کاری واقعی و نرخ پذیرش: اگر بار کاری سرور افزایش یابد و بچسایز به حد بهینه برسد، استفاده مداوم از رمزگشایی حدسی در واقع به هدر دادن توان محاسباتی منجر میشود؛ بهویژه اگر نرخ پذیرش (Acceptance Rate) مدل پیشنویس پایین باشد.
- تنظیمات فریمورکها: به همین دلیل است که ابزارهای سرویسدهی مثل vLLM پارامترهایی مانند
--speculative-disable-by-batch-sizeرا در اختیار مهندسان قرار میدهند تا در بچسایزهای بالا، این قابلیت به طور خودکار غیرفعال شود. - پژوهشهای نوین (مانند dSpark): این بینش باعث شده محققان به فکر استراتژیهای پویا بیفتند؛ یعنی به جای حدسزدنِ عمیق در همه شرایط، عمق حدسزدن بر اساس بار کاری و بچسایز فعلی به صورت پویا تنظیم شود.
این مطلب بهصورت کاملاً خودکار و با هوش مصنوعی از مقالهٔ اصلی و بحث هکرنیوز تهیه شده و ممکن است خطا داشته باشد. حقوق مطلب اصلی متعلق به نویسندهٔ آن است. قوانین و گزارش مشکل