نسخه اصلاحشده Qwen3-4B؛ حذف لحن و الگوهای کلیشهای هوش مصنوعی — Show HN: Qwen3-4B with the AI writing tics trained out
خلاصه
این مقاله به معرفی نسخهای سفارشیسازیشده از مدل Qwen3-4B میپردازد که برای حذف کلمات تکراری و لحن کلیشهای موسوم به AI slop بهینهسازی شده است. این تلاش پاسخ ملموسی به خستگی برنامهنویسان و نویسندگان از الگوهای زبانی تکراری در خروجی مدلهای زبانی بزرگ است.
زمینه و مفاهیم پایه
مدلهای زبانی بزرگ (LLM) امروزی، به دلیل استفاده از مجموعهدادههای آموزشی مشابه و دستورالعملهای یکسان، معمولاً لحن، واژگان و ساختارهای نگارشی تکرارپذیری تولید میکنند. این الگوهای تکراری که جامعهی توسعهدهندگان به آن اصطلاحاً AI slop میگویند، شامل استفادهی بیش از حد از برخی قیدها، عبارتهای گذار کلیشهای و ساختارهای جملهبندی خاصی است که به سرعت برای مخاطب انسانی قابل شناسایی میشوند. این موضوع باعث شده است تا خروجی ابزارهای هوش مصنوعی یکنواخت و کسلکننده به نظر برسد.
جزئیات فنی و پروژه Qwen3-4B
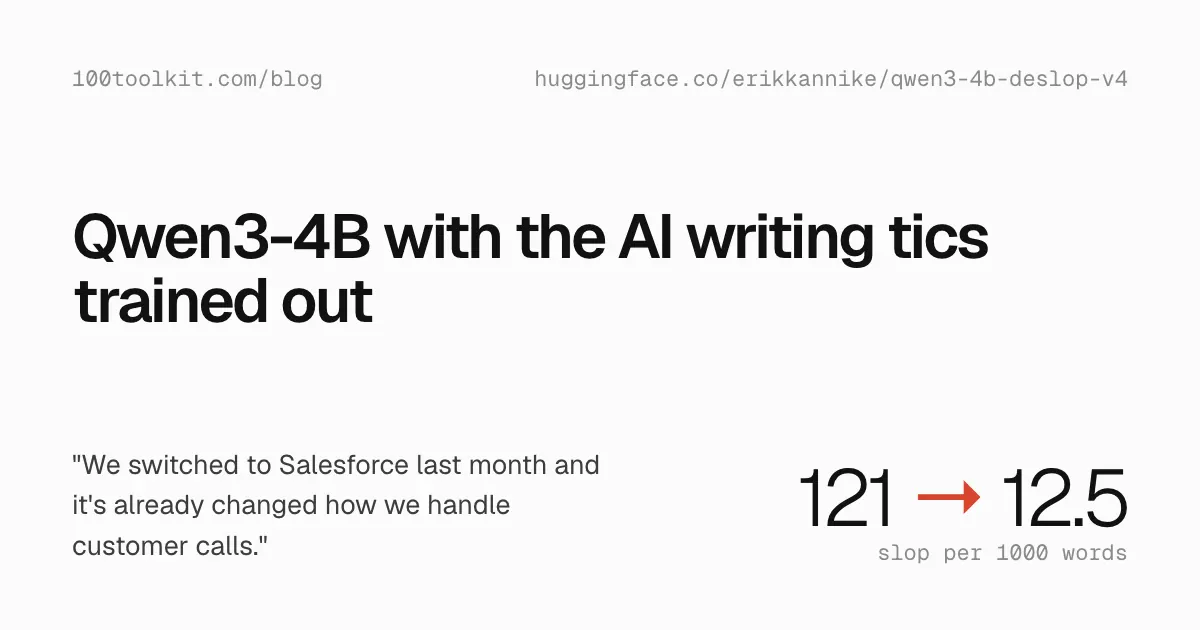
پروژهی جدید روی مدل Qwen3-4B تمرکز دارد تا این مدل را از «تیکهای عصبی زبانی» یا همان عادتهای نگارشی آزاردهنده پاکسازی کند. سازندگان این نسخه با بررسی پاسخهای مدل روی مجموعهای از پرامپتهای تست (held-out prompts) در ژانرها و موضوعات مختلف، تلاش کردهاند بدون نیاز به System Promptهای پیچیده، مدل را وادار به تولید متنهای طبیعیتر و انسانیتر کنند.
بر اساس ارزیابیهای انجامشده با ابزارهای تشخیص اسلاپ (slop detector)، الگوهای زبانی خاصی که به عنوان نشانههای مشخصهی مدلهای هوش مصنوعی شناخته میشوند، در این نسخه به شدت کاهش یافتهاند.
دیدگاهها و بحثهای جامعهی Hacker News
این پروژه بازخوردهای متعددی را در Hacker News به همراه داشته است:
- خستگی از یکنواختی: برخی کاربران اشاره کردهاند که وقتی همهی مدلها از الگوهای زبانی مشابهی استفاده میکنند، خواننده به سرعت از آنها خسته میشود؛ درست مانند این است که تمام کتابهای جهان توسط چند نفر معدود نوشته شده باشند.
- چالش نشانهگذاریها: در میان نظرات، بحثهایی دربارهی حذف علامتهایی مثل Em dash مطرح شد. برخی توسعهدهندگان معتقدند این علامتها کاملاً قانونی و تایپوگرافیک هستند و نباید بهکل حذف شوند.
- تناقض در رفتار مدلها: کاربران به این تناقض اشاره کردند که از یک سو گفته میشود LLMها غیرقطعی و غیرقابل پیشبینی هستند، اما از سوی دیگر همگی خروجیها، رابطهای کاربری و متنهایی با یک سبک واحد تولید میکنند.
- پروژههای مشابه: کاربران به نمونههای دیگری مانند مدل
gemma-3-27b-it-antislopنیز اشاره کردند که نشان میدهد تلاش برای رفع این مشکل در مدلهای دیگر در ابعاد بزرگتر نیز در حال انجام است.
چرا این موضوع برای مهندسان اهمیت دارد؟
برای توسعهدهندگانی که از LLMها در تولید محتوا، مستندسازی یا برنامههای کاربردی استفاده میکنند، کیفیت و طبیعی بودن متن خروجی حیاتی است. خروجیهای کلیشهای به سرعت توسط کاربران نهایی پس زده میشوند. این رویکرد نشان میدهد که چگونه میتوان با اصلاح پس از آموزش (Post-training) یا تنظیم دقیق مدلها، خروجیهای تمیزتر و کاربردیتری بدون اتکا به پرامپتهای طولانی به دست آورد.
این مطلب بهصورت کاملاً خودکار و با هوش مصنوعی از مقالهٔ اصلی و بحث هکرنیوز تهیه شده و ممکن است خطا داشته باشد. حقوق مطلب اصلی متعلق به نویسندهٔ آن است. قوانین و گزارش مشکل