شبکههای سلسلهمراتبی (H-Nets): گامی فراتر از توکنایزرها در مدلهای زبانی — Scaling Hierarchical Networks
خلاصه
مقاله شرکت Cartesia به بررسی شبکههای سلسلهمراتبی (H-Nets) به عنوان جایگزینی یادگیریشده برای توکنایزرهای دستی در مدلهای زبانی میپردازد. این معماری جدید با پردازش دادهها در سطح بایت و بخشبندی پویا، کارایی محاسباتی مدلها را به طور چشمگیری افزایش میدهد.
مقدمه و زمینه
از زمان انتشار مقاله تاثیرگذار «درس تلخ» (The Bitter Lesson) توسط ریچارد ساتمن در سال ۲۰۱۹، صنعت هوش مصنوعی به سمت استفاده از روشهای عمومی و مقیاسپذیر متمایل شده است که وابستگی کمتری به پیشفرضهای مهندسیشده توسط انسان دارند. در حوزه مدلهای زبانی بزرگ (LLM)، معماری Transformer و پیشبینی توکن بعدی انقلابی به پا کردهاند؛ اما یک بخش حیاتی همچنان به صورت دستی و غیريادگیریپذیر باقی مانده است: توکنایزر (Tokenizer).
روشهای رایج مانند BPE (Byte Pair Encoding) متن را پیش از ورود به مدل به تکههای ثابتی تبدیل میکنند. این رویکرد دستی محدودیتی جدی در یادگیری سرتاسری (End-to-End) ایجاد میکند. حالا شرکت Cartesia در مقالهای جدید به سراغ شبکههای سلسلهمراتبی یا H-Nets رفته است تا با جایگزینی توکنایزرهای سنتی با مدلهای یادگیریشده در سطح بایت، این مانع را کنار بزند.
شبکههای سلسلهمراتبی (H-Nets) چیستند؟
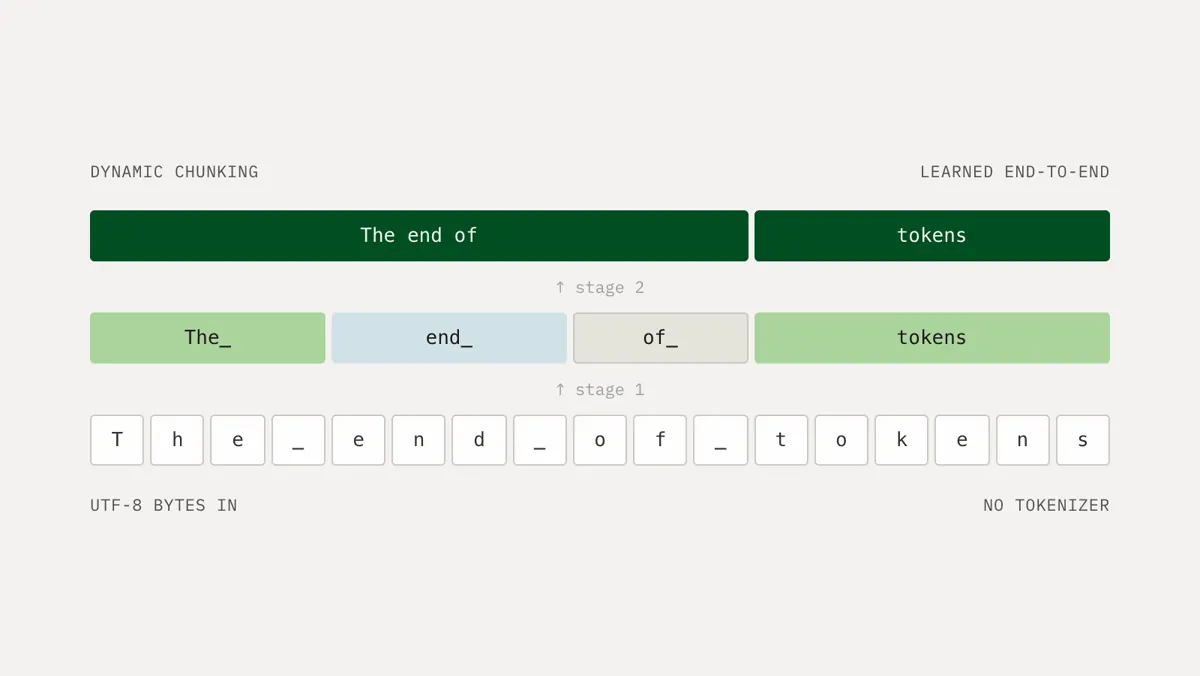
الهامگرفته از مفهوم دستهبندی یا chunking در روانشناسی شناختی، H-Nets به مدل اجازه میدهند تا دادههای سطح پایین (مانند بایتهای UTF-8) را به صورت بازگشتی به مفاهیم انتزاعیتر تبدیل کند (بایتها به کلمات، کلمات به عبارتها و عبارتها به مفاهیم).
برخلاف BPE که پیش از آموزش مدل و به صورت آفلاین انجام میشود، H-Nets فرآیند بخشبندی دادهها را به صورت پویا و در داخل خودِ شبکه عصبی انجام میدهند. این ساختار شامل بخشهای زیر است:
- انکودر و دیکودر (Outer Networks): مسئول تبدیل پویا و سلسلهمراتبی بایتها به تکهها (Chunks) و بالعکس.
- شبکه اصلی (Inner Network): بخش مرکزی مدل که روی این تکههای استخراجشده عملیات پردازش زبانی را انجام میدهد.
مقایسه و نتایج مقیاسپذیری (Scaling Ladders)
تیم تحقیق Cartesia برای اثبات کارایی H-Nets، یک ساختار مقایسهای دقیق میان مدلهای مبتنی بر BPE و مدلهای H-Net یکمرحلهای ایجاد کرد:
- کنترل دقیق دادهها: حجم دادهها، مرز اسناد و ترکیب آنها (۷۰ درصد انگلیسی، ۲۰ درصد کد، ۵ درصد ریاضی و ۵ درصد چندزبانه) بین مدل بایتمحور و BPE کاملاً یکسان نگه داشته شد.
- بهرهوری محاسباتی: مدلهای H-Net یکمرحلهای توانستند بهبود کارایی محاسباتی معناداری (بین ۳ تا ۵ برابر) به دست آورند.
- عملکرد در زیردامنهها: در حوزههایی مانند پردازش کد، بهبود کیفیت تا ۲ برابر در ارزیابی درونتوزیعی و تا ۵ برابر در ارزیابی برونتوزیعی (Out-of-Distribution) مشاهده شد.
علاوه بر این، نسخه پیشرفتهتر دو مرحلهای H-Net توانست با ۱۰ برابر داده و محاسبات کمتر، عملکردی رقابتی یا حتی بهتر نسبت به مدلهای متنباز موجود ارائه دهد.
چرا این موضوع برای مهندسان اهمیت دارد؟
برای توسعهدهندگان و مهندسان هوش مصنوعی، وابستگی به توکنایزرها همواره یک دردسر پنهان بوده است (مشکلاتی مانند توکنهای ناشناخته، رفتار ضعیف روی کدهای غیرانگلیسی یا کاراکترهای خاص). شبکههای سلسلهمراتبی نشان میدهند که میتوان توکنایزر را کاملاً حذف کرد و آن را به یک لایه یادگیریپذیر تبدیل نمود.
نکته هیجانانگیزتر این است که H-Nets محدود به متن نیستند. از آنجا که این معماری روی دادههای خام و پیوسته (مانند دادههای زیستشناسی و بینایی ماشین) نیز قابل اجراست، راه را برای ساخت مدلهای عمومیتر و چندوجهی (Multimodal) هموار میکند که به طور مستقیم از دادههای خام یاد میگیرند.
این مطلب بهصورت کاملاً خودکار و با هوش مصنوعی از مقالهٔ اصلی و بحث هکرنیوز تهیه شده و ممکن است خطا داشته باشد. حقوق مطلب اصلی متعلق به نویسندهٔ آن است. قوانین و گزارش مشکل