بهینهسازهای واکنشی: بازنویسی خودکار کدهای بهینهسازی در جریان آموزش مدل — Reactive Optimizers: rewrite the optimizer's source code during training
خلاصه
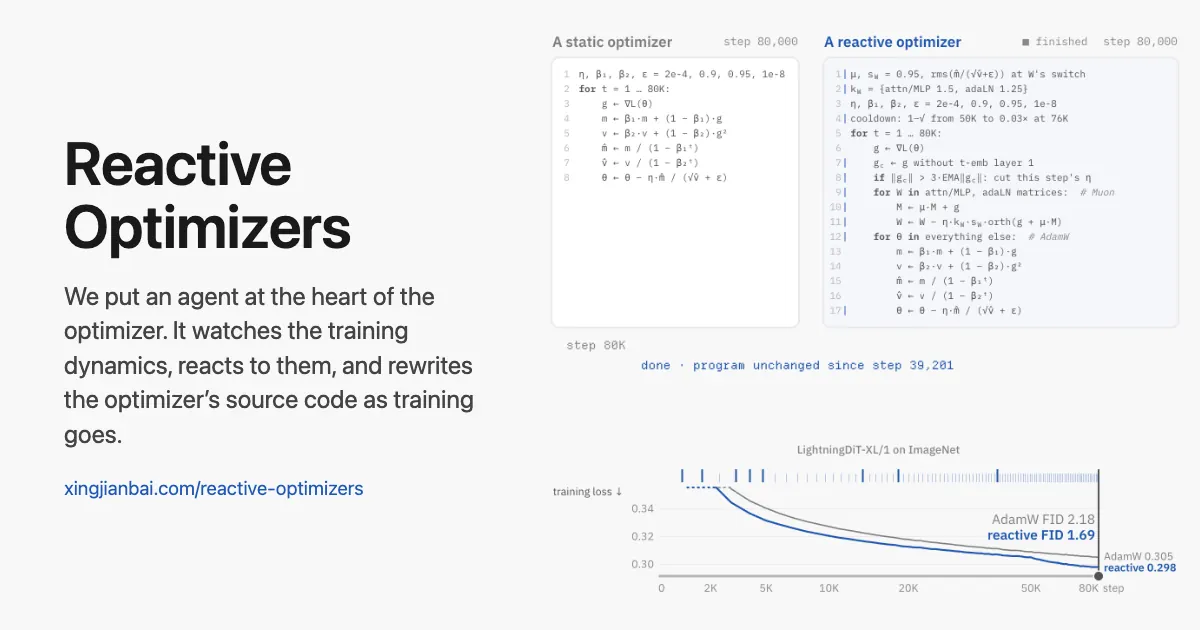
بهینهسازهای واکنشی با قرار دادن یک عامل هوش مصنوعی در قلب فرآیند آموزش مدل، کدهای بهینهساز و تحلیلگر را در لحظه بازنویسی میکنند. این روش صفرشات به توسعهدهندگان اجازه میدهد بدون نیاز به تنظیم دقیق و ازپیشتعیینشدهی دستورالعملها، عملکردی برابر یا بهتر از بهترین حالتهای دستی به دست آورند.
مقدمه و زمینه
امروزه در دنیای یادگیری ماشین، دستورالعمل (Recipe) و هایپرپارامترهای بهینهساز یک مدل پیش از شروع آموزش کاملاً تعیین میشوند. فرآیندهایی نظیر نرخ یادگیری تطبیقی، پیششرطسازی و برنامههای زمانی نرخ یادگیری همگی از پیش نوشته شده و تا انتهای فرآیند آموزش به همان شکل اجرا میشوند. این رویکرد سنتی پرسشهای بیشماری را بیответ میگذارد: اگر در میانهی راه با یک جهش ناگهانی در Loss مواجه شویم چه باید کرد؟ اگر گرادیانهای یک ماژول دچار نوسان شوند چطور؟
مقاله جدیدی که بستهای به نام OPAL (مخفف OPtimizer with an Agent in the Loop) را معرفی میکند، پاسخی به همین دغدغههاست. این روش رویکرد سنتی را کنار گذاشته و یک عامل (Agent) را در مرکز بهینهساز قرار میدهد تا دینامیک آموزش را زیر نظر بگیرد، نسبت به آن واکنش نشان دهد و کدهای سورس بهینهساز را در طول مسیر بازنویسی کند.
جزییات فنی و نحوه کارکرد
هسته اصلی این سیستم بر پایه دو اسکریپت پایتون استوار است که عامل هوش مصنوعی (در اینجا مدل Claude Opus 5.5) میتواند آنها را در حین آموزش بازنویسی کند:
- اسکریپت
analysis.py: از آنجا که ارسال تمام وزنها و اکتیویشنها به عامل غیرممکن است، عامل این اسکریپت را مینویسد تا معیارهای آماری و هندسی مورد نیاز خود را استخراج کند؛ معیارهایی مانند نرم گرادیان هر گروه پارامتر، اندازه بهروزرسانیها نسبت به وزنها و کسینوس زاویه بین گرادیانهای متوالی. - اسکریپت
updater.py: این اسکریپت در هر گام بهینهسازی اجرا میشود و قانون بهروزرسانی وزنها را پیادهسازی میکند. عامل با تغییر این کد میتواند قوانین پیچیدهای اعمال کند.
با این ساختار دوطرفه، عامل میتواند استراتژیهای پیچیدهای مثل تستهای A/B آنی روی نرخهای یادگیری مختلف، افزایش یا کاهش پویای نرخ یادگیری بر اساس نوسانات گرادیان و فرار از بیشبرازش (Overfitting) را بهصورت خودکار پیادهسازی کند.
نتایج و کارایی
آزمایشها نشان میدهند که این رویکرد واکنشی در سناریوهای مختلف عملکرد بسیار خوبی دارد:
- در وظایف مدلهای زبانی بزرگ روی دیتاستهای جایگزین (مانند زبانهای چینی، تایلندی و قرقیزی) که هیچ دستورالعمل ازپیشتنظیمشدهای ندارند، این روش با بهترین رقبای لیدربورد رقابت کرده یا آنها را شکست میدهد.
- در کارهای تولید تصویر (Image Generation) روی مدلهای انحصاری دیفیوژن مانند
LightningDiT-XL/1وRAEv2-B، بهینهساز واکنشی توانسته است نتایج بهتری نسبت به دستورالعملهای رسمی به دست آورد.
دیدگاه جامعه هکرنیوز
در بحثهای انجامشده در Hacker News، کاربران به کاربردهای جذاب دیگری برای این ایده اشاره کردهاند؛ از جمله استفاده از بهینهسازهای واکنشی برای تنظیم پویای ترکیب دادههای آموزشی (Data Mix) و تصمیمگیری درباره نحوه انتخاب و ارزشگذاری تریسهای یادگیری تقویتی (RL) در مرحله پسآموزش.
این مطلب بهصورت کاملاً خودکار و با هوش مصنوعی از مقالهٔ اصلی و بحث هکرنیوز تهیه شده و ممکن است خطا داشته باشد. حقوق مطلب اصلی متعلق به نویسندهٔ آن است. قوانین و گزارش مشکل