نگاهی به درون پرومتئوس؛ ابرکلاستر مقیاس گیگاواتی متا برای هوش مصنوعی — Meta's GB{2,3}00 Cluster
خلاصه
شرکت متا جزئیات زیرساخت هوش مصنوعی عظیم خود به نام پرومتئوس را منتشر کرد که با هدف مقیاسپذیری تا یک میلیون پردازنده گرافیکی و استفاده از معماریهای پیشرفته انویدیا طراحی شده است. این مقاله چالشهای شبکه، خنکسازی مایع و مدیریت پایداری در مقیاسهای کلان را بررسی میکند.
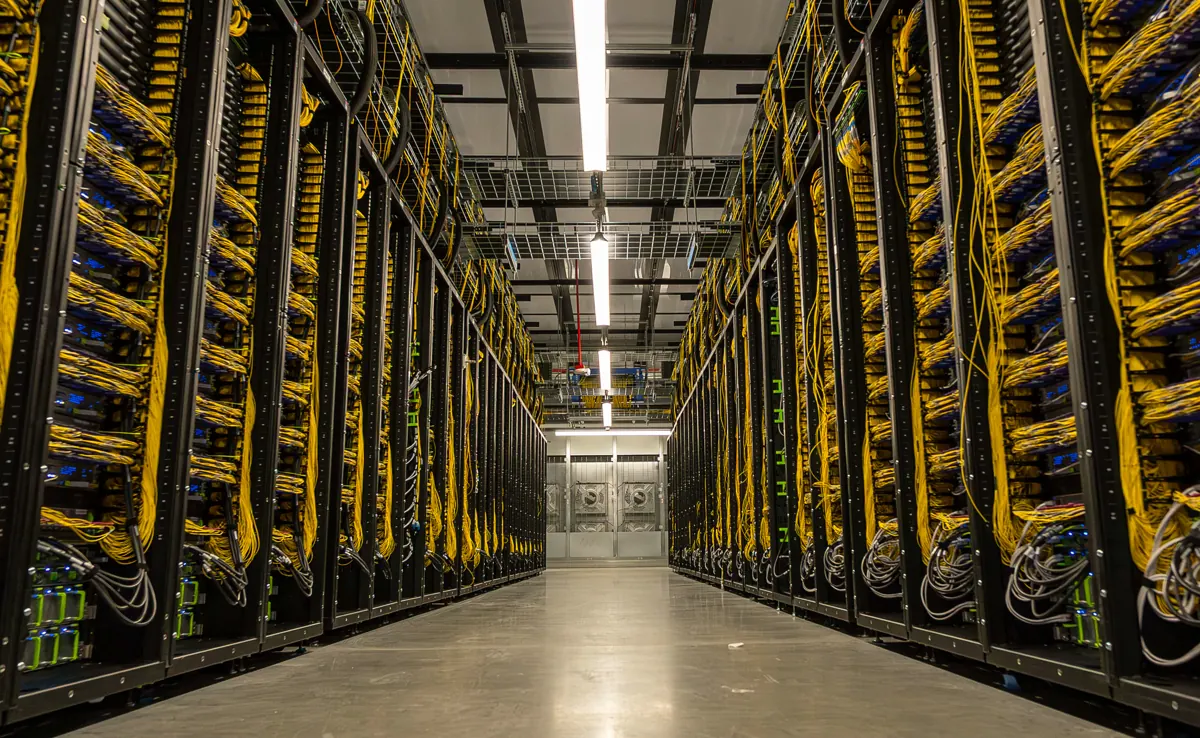
متا جزئیات فنی یکی از جاهطلبانهترین پروژههای زیرساختی خود در زمینه هوش مصنوعی را منتشر کرده است. پروژه پرومتئوس (Prometheus) یک ابرکلاستر با مقیاس گیگاواتی در ایالت اوهایو است که برای آموزش نسل بعدی مدلهای بنیانین و عاملیتهای هوش مصنوعی توسعه یافته و هدف نهایی آن مقیاسپذیری تا حدود یک میلیون GPU است.
پسزمینه و معماری سختافزاری
پرومتئوس در فازهای مختلف توسعه یافته و اولین فاز آن برای آموزش مدلهای خانواده Muse استفاده شده است. این زیرساخت از نسلهای مختلف پردازندههای گرافیکی انویدیا بهره میبرد:
- پلتفرم Catalina (مدل GB200 NVL72): ترکیبی از ۳۲ پردازنده گرافیکی Blackwell و پردازندههای Grace با اتصال داخلی NVLink و پشتیبانی از پهنای باند مقیاسخارج (Scale-out) معادل 800G در هر GPU.
- پلتفرم Clemente (مدل GB300 NVL72): نسخه ارتقایافتهای که ظرفیت حافظه HBM را به میزان ۵۰ درصد افزایش داده (۲۸۸ گیگابایت به ازای هر GPU) و از کارتهای شبکه ConnectX-8 با پهنای باند بومی 800G استفاده میکند.
شبکه کلاستر و ارتباطات بکاند
برای آموزش مدلهای بزرگ در مقیاس کلاستر، معماری شبکه سنتی وب پاسخگو نیست. متا یک شبکه اختصاصی دوم بر بستر اترنت به نام Backend (BE) را برای ارتباط مستقیم GPU به GPU پیادهسازی کرده است:
- ارتباطات درونساختمانی (Building-level): استفاده از توپولوژیهای پیشرفته مانند Disaggregated Scheduled Fabric یا Non-Scheduled Fabric بر پایه سوئیچهای 51.2T و پشته شبکه اختصاصی FBOSS برای جلوگیری از ازدحام دادهها.
- شبکه تج تجمیع (BAG): اتصال ساختمانهای مختلف کلاستر در فواصل طولانی با استفاده از سوئیچهای مجهز به سیلیکون Jericho3 و اپتیکهای انسجامیافته 800G-ZR.
تابآوری و مدیریت خرابی در مقیاس ۷۲-GPU
گسترش دامنه مقیاسپذیری داخلی به ۷۲ پردازنده گرافیکی در رکهای NVL72، شعاع انفجار خرابی (Fault Blast Radius) را به شدت افزایش داده است. متا برای مدیریت این چالش از راهبردهای زیر بهره میبرد:
- استفاده از واحدهای یدکی درون رک (In-rack Spares): هر دامنه ۷۲ تایی از یک اسلایس ۶۴-GPU به عنوان واحد اصلی و ۸ GPU به عنوان یدک تشکیل شده است تا در صورت خرابی، جایگزینی فوری انجام شود.
- همکاری مهندسی عمیق با انویدیا: اشتراکگذاری دادههای تلهمتری در زمان واقعی و ریشهیابی دقیق هر توقف سیستم برای بهبود فریمور و پایداری کلی.
چرا این موضوع برای مهندسان اهمیت دارد؟
برای مهندسان سیستم و زیرساخت، پرومتئوس نشاندهنده استانداردهای نوینی در مهندسی مراکز داده است. دستیابی به نرخ بهرهور (Goodput) بیش از ۸۵ درصد در آموزشهای پیشاموزش و بیش از ۹۰ درصد در یادگیری تقویتی، نیازمند هماهنگی دقیق میان سختافزار، لایههای شبکه، خنکسازی مایع و مدیریت خطاست که میتواند الگویی برای طراحی ابرکلاسترهای آینده باشد.
این مطلب بهصورت کاملاً خودکار و با هوش مصنوعی از مقالهٔ اصلی و بحث هکرنیوز تهیه شده و ممکن است خطا داشته باشد. حقوق مطلب اصلی متعلق به نویسندهٔ آن است. قوانین و گزارش مشکل