بررسی عملکرد ایجنتهای هوش مصنوعی در بازی پوکمون؛ همکاری یا گفتگو؟ — LLM agents play Pokemon showdown
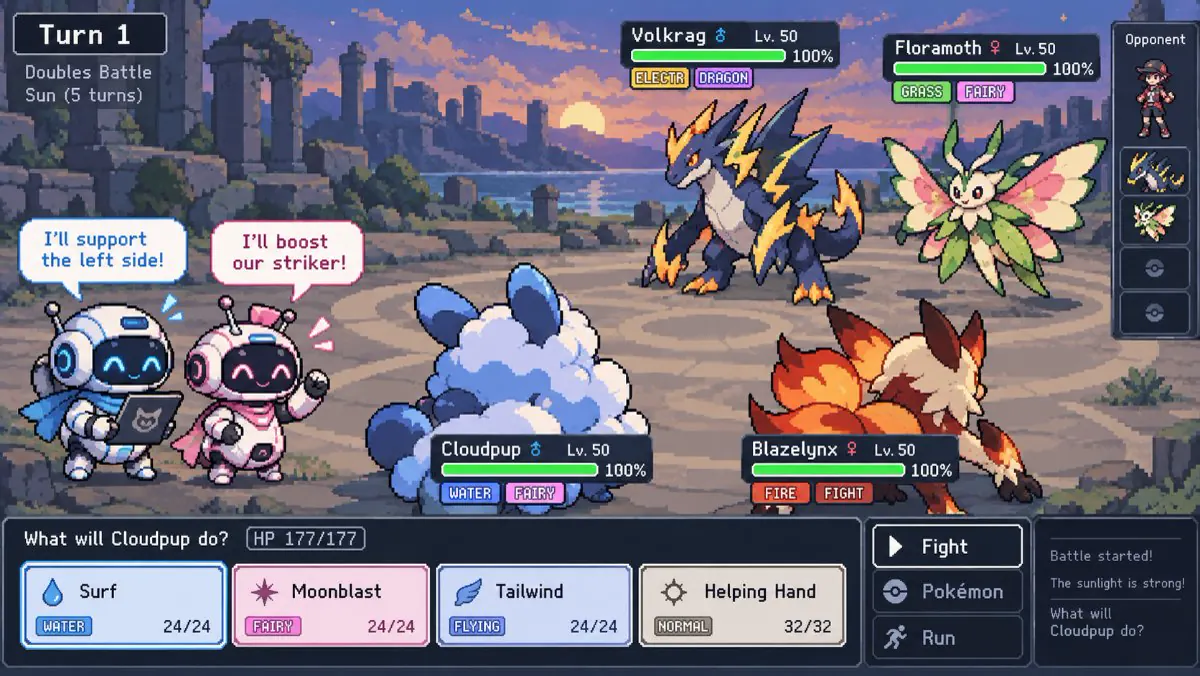
خلاصه
این مقاله به بررسی نحوه هماهنگی و ارتباط میان ایجنتهای مبتنی بر LLM در محیط مسابقهای پوکمون (Pokémon Showdown) میپردازد. نتایج نشان میدهد که گفتگوی آزاد بین ایجنتها نرخ برد را افزایش میدهد، اما هزینه توکن و پردازش را نیز به شدت بالا میبرد.
مقدمه و زمینه
بیشتر تحقیقات مربوط به سیستمهای چند ایجنته (Multi-agent) روی جریانهای کاری خطی تمرکز دارند که در آن وظایف به صورت خطی بین ایجنتها پاسکاری میشود. اما آینده هوش مصنوعی در گروی همکاری واقعی، برقراری ارتباط و مذاکره بین ایجنتها است. برای سنجش این تواناییها، یک محیط پویا و مبتنی بر تئوری بازیها نیاز است که اطلاعات کامل در آن وجود نداشته باشد. بازی Pokémon Showdown در فرمت مسابقات دوبهدو (2v2)، بستر مناسبی برای این تحقیق فراهم کرده است؛ زیرا اطلاعات حریف پنهان است، آسیبها تصادفی هستند و پیروزی نیازمند استراتژی، خواندن دست حریف و هماهنگی دقیق با همتیمی است.
جزئیات فنی و پیادهسازی
این محیط روی پلتفرم Pokémon Showdown و با الهام از معماری Gym پیادهسازی شده است. در هر نوبت:
- هر ایجنت خلاصه متنی وضعیت نبرد و لیستی شمارهگذاریشده از حرکات قانونی خود را دریافت میکند.
- ایجنتها میتوانند پیش از انتخاب نهایی، پیامهای خصوصی به یکدیگر ارسال کنند.
- پس از انتخاب حرکت، همتیمی مطلع میشود که چه تصمیمی گرفته شده است.
برای ارزیابی، مدل Qwen3.8-27B در برابر یک بات اسکریپتشده با بیشترین میزان آسیب (Max-damage bot) قرار گرفت. حالتهای مختلفی برای گفتگو تعریف شد:
- گفتگوی آزاد (Free talk): ایجنتها تا زمان انتخاب نهایی میتوانند به گفتگو ادامه دهند.
- یک پیام (One message each): هر ایجنت تنها یک بار میتواند به همتیمیاش پیام دهد.
- بدون گفتگو (No talk): هیچ ارتباطی بین ایجنتها وجود ندارد.
- مدل واحد: یک مدل کنترل هر دو پوکمون را بر عهده دارد.
نتایج و یافتهها
نتایج آزمایشها نکات جالب توجهی را آشکار کرد:
- نقش مثبت گفتگو: تیمی که از گفتگوی آزاد بهره میبرد، ۶۴ درصد نبردها را برد؛ در حالی که تیمهای بدون گفتگو تنها ۴۲ درصد پیروز شدند. حتی تبادل یک پیام ساده (۵۲ درصد) نیز عملکرد بهتری نسبت به قطع ارتباط داشت.
- مقایسه با مدل واحد: مدلی که هر دو پوکمون را کنترل میکرد به نرخ برد ۵۴ درصد رسید. این یعنی بهبود عملکرد ناشی از پویاییِ مکالمه و تبادل نظر است، نه صرفاً تفکر متمرکز توسط یک ذهن.
- هزینه محاسباتی: گفتگوی آزاد نیازمند حدود ۹۷۸ هزار توکن پرامپت در هر نبرد بود که تقریباً ۳.۸ برابر حالت بدون گفتگو (۲۵۹ هزار توکن) محسوب میشود.
- قدرت تفکیک بنچمارک: تیمهای قویتر عملکرد به مراتب بهتری داشتند؛ به طوری که تیم Qwen توانست ۹۶ درصد بازیها را در برابر مدلهای ضعیفترِ ۲ میلیارد پارامتری ببرد.
چرا این موضوع برای مهندسان اهمیت دارد؟
این پروژه نشان میدهد که چگونه میتوان محیطهای کنترلشدهای برای سنجش رفتار همکاری و ارتباط بین ایجنتها ساخت. در حالی که کارهای آینده روی بهبود این محیط به عنوان یک بنچمارک استاندارد و استفاده از یادگیری تقویتی (RL) برای تقویت رفتارهای مشارکتی تمرکز دارد، چالش اصلی تعادل میان کیفیت تصمیمگیری (از طریق گفتگو) و هزینههای سرسامآور توکنهای مصرفی است.
حاشیهها و بحثهای هکرنیوز
در بخش نظرات Hacker News، کاربران به نکات مختلفی اشاره کردند؛ از جمله درام اخیر پیرامون آموزش یک بات قدرتمند برای پوکمون با استفاده از یادگیری تقویتی و بازنویسی موتور بازی به زبان Rust برای موازیسازی خودپشتیبان (Self-play)، تا این بحث که آیا پیامرسانی صرفاً پروکسی برای استدلال بیشتر مدل است یا خیر.
این مطلب بهصورت کاملاً خودکار و با هوش مصنوعی از مقالهٔ اصلی و بحث هکرنیوز تهیه شده و ممکن است خطا داشته باشد. حقوق مطلب اصلی متعلق به نویسندهٔ آن است. قوانین و گزارش مشکل