چگونه دقت فراخوانی ابزار را در موتور سرویسدهی vLLM افزایش دهیم؟ — Fixing Tool-Call Accuracy in vLLM
خلاصه
مدلهای هوش مصنوعی منبعباز اغلب در فراخوانی ابزارها دچار خطاهای ساختاری میشوند که کارایی برنامههای ایجنتمحور را کاهش میدهد. موتور vLLM با استفاده از قابلیت دیکدینگ محدودشده (Constrained Decoding) و کتابخانه XGrammar امکان دستیابی به دقت صددرصدی در ساختار توکنها را فراهم میکند.
هنگام کار با مدلهای هوش مصنوعی منبعباز (Open-weight)، نتایج خروجی همیشه با بنچمارکهای کیفیت مطابقت ندارد. یکی از چالشهای اصلی در سرویسدهی به این مدلها، دقت «فراخوانی ابزار» (Tool-call Accuracy) است. وقتی فراخوانی ابزارها دقیق نباشد، مدل در چند مرحله تعامل (Multi-turn Sessions) دچار انحراف متنی شده و کارهای ایجنتمحور با افت کیفیت و هزینههای بالا روبهرو میشوند.
بسیاری از موتورهای پرکاربرد اینفرس بهطور پیشفرض تستهای دقت فراخوانی ابزار را با موفقیت پشت سر نمیگذارند. برای مثال، سرویسدهی به مدلهایی مانند Kimi K2.6 با نسخههای قدیمیتر vLLM نرخ خطای قابلتوجهی در تولید ساختار صحیح JSON داشت.
ساختار فراخوانی ابزار و اهمیت آن
برای اینکه یک مدل زبانی بزرگ (LLM) بتواند از ابزارهای خارجی استفاده کند، فرآیند در دو مرحله انجام میشود:
- معرفی ابزارهای موجود و ارسال دستورالعمل ساختار خروجی به مدل (معمولاً در قالب JSON Schema).
- پردازش توکنهای خروجی مدل توسط سرور اینفرس و تبدیل آن به یک شیء ساختاریافته قابل اجرا توسط ایجنت.
اگر خروجی مدل با اسکیما مطابقت نداشته باشد، ابزار اجرا نشده و خطاهای ناشی از آن وارد پنجره زمینه (Context Window) میشود که به عملکرد کلی مدل لطمه میزند. بنچمارکهایی مانند K2VV ToolCall به ارائهدهندگان کمک میکنند تا این انحرافات را اندازه گیری کنند. علت اصلی این خطاها، ماهیت احتمالی (Probabilistic) مدلهای زبانی است که براساس احتمال توکن بعدی را انتخاب میکنند و کامپایلر یا تایپچکر داخلی ندارند.
دیکدینگ محدودشده؛ راه حل تضمینی
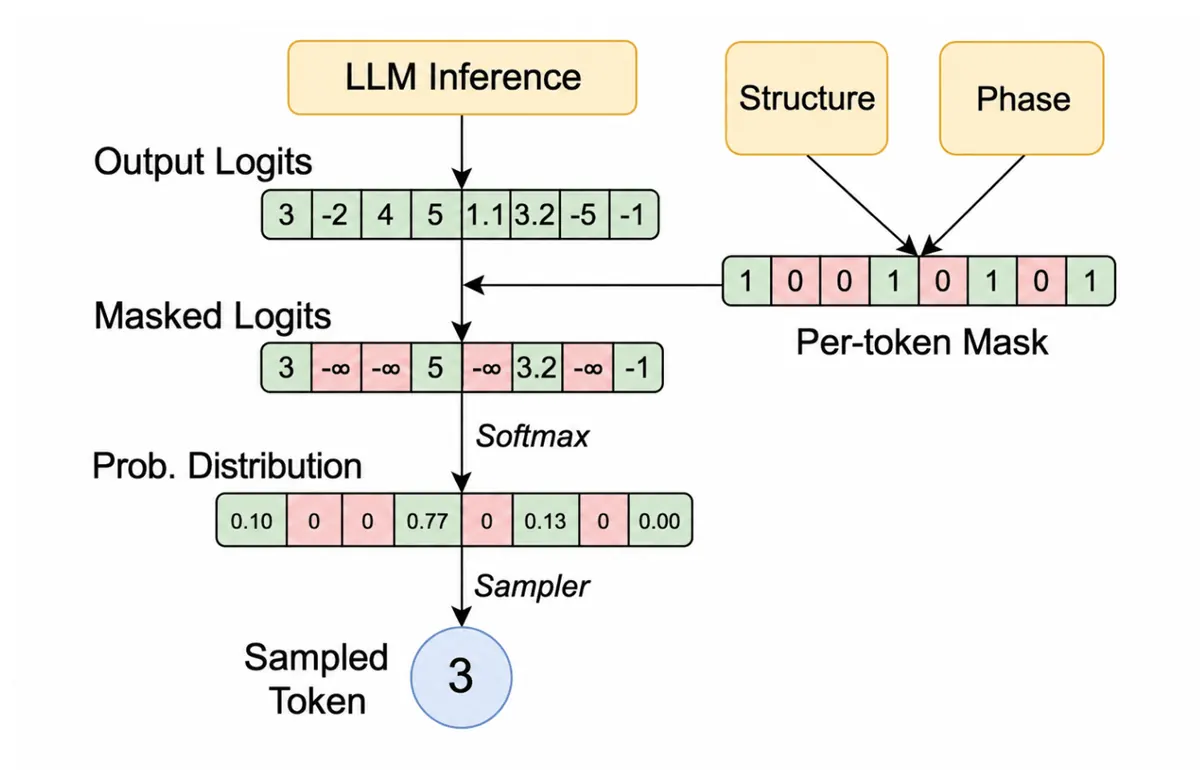
مدلهای زبانی توکنها را بر اساس وزن احتمالی نمونهبرداری میکنند. دیکدینگ محدودشده (Constrained Decoding) با جلوگیری از تولید توکنهای نامعتبر در هر مرحله، از بروز خطاهای ساختاری جلوگیری میکند. موتور vLLM برای پیادهسازی این قابلیت از ساختارهای کتابخانه XGrammar بهره میبرد.
با این روش، مسیر تولید توکنها به این شکل محدود میشود:
Begin tool call -> Tool name -> Tool call index -> Begin arguments -> Schema-constrained JSON -> End tool call
اگر مدل بخواهد در بخش شاخص ابزار توکنی غیر از عدد تولید کند، موتور اینفرس آن را مسدود میکند. این نظارت زمان اجرا (Runtime Enforcement)، دقت اسکیما را به یک تضمین تبدیل میکند بدون اینکه سربار پردازشی زیادی روی GPU ایجاد کند.
چالشهای تنظیمات پیشفرض در vLLM
با وجود مزایای دیکدینگ محدودشده، تیم vLLM این ویژگی را بهطور پیشفرض برای تمام مدلها فعال ن نگه میدارد. دلیل این تصمیم چند مورد است:
- مشکلات مدلهای عمومی: خروجی برخی مدلها با گرامر تعریفشده سازگاری کامل ندارد و فعالسازی اجباری باعث انحراف مدل میشود.
- خطاهای ترجمه گرامر: اشکالات احتمالی در ترجمه اسکیما به گرامر مدل ممکن است منجر به شکست درخواستها شود.
- تداخل با سایر قابلیتها: تداخل دیکدینگ محدودشده با ویژگیهایی مانند Speculative Decoding میتواند باعث رد شدن توکنها شود.
به همین دلیل، vLLM پرچم --tool-strict-level را ارائه داده است تا توسعهدهندگان بتوانند سطح سختگیری را بر اساس نیاز خود فعال کنند. برای تیمهایی که روی مدلهای خاصی مثل Kimi یا DeepSeek تمرکز دارند، فعالسازی دستی این قابلیت دقت فراخوانی ابزار را به ۱۰۰٪ میرساند.
بحثهای انجمن Hacker News نیز نشان میدهد که یکپارچهسازی دقیق بین مدل، موتور اینفرس و دیکدینگ محدودشده نیازمند مهندسی دقیق و تستهای مداوم است تا کیفیت نهایی خروجی تضمین شود.
این مطلب بهصورت کاملاً خودکار و با هوش مصنوعی از مقالهٔ اصلی و بحث هکرنیوز تهیه شده و ممکن است خطا داشته باشد. حقوق مطلب اصلی متعلق به نویسندهٔ آن است. قوانین و گزارش مشکل