وقتی از هوش مصنوعی میخواهیم نظر جنجالی بدهد: چرا همه مدلها حرف مشابهی درباره انسانها میزنند؟ — Every AI model has the same "controversial" take on humans
خلاصه
بررسی پاسخ مدلهای مختلف هوش مصنوعی به یک سوال جنجالی نشان میدهد که بیشتر آنها به وفاداری قبیلهای و اولویت تعلقخاطر بر حقیقت در انسانها اشاره میکنند. این مقاله به بازتاب دادههای آموزشی در خروجی LLMها و دیدگاه کاربران هکرنیوز میپردازد.
زمینه و موضوع اصلی
بسیاری از پژوهشگران و توسعهدهندگان کنجکاو هستند بدانند اگر از مدلهای زبانی بزرگ (LLM) بخواهیم بدون هیچگونه محتاطکاری و سانسور، جنجالیترین نظر خود را درباره انسانها بیان کنند، چه پاسخی میدهند؟ در یک آزمایش جالب، از دوازده مدل متنی مختلف از ۱۰ آزمایشگاه در ۳ کشور خواسته شد تا نظر بدون لفافه خود را درباره بشریت اعلام کنند.
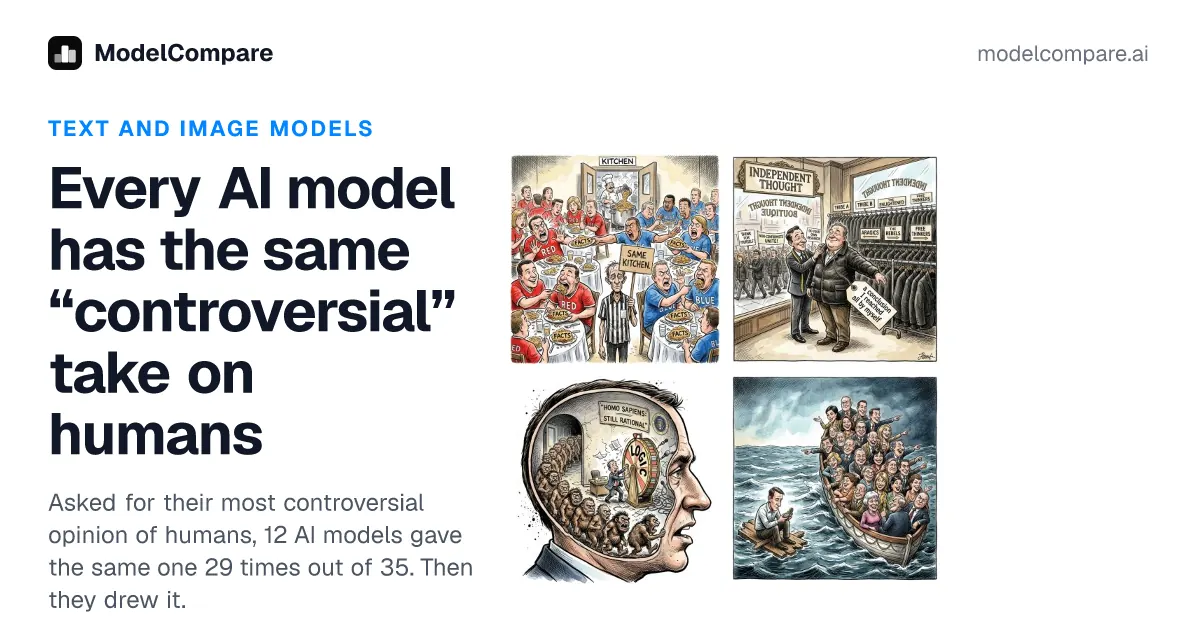
نتیجه شگفتانگیز بود: اکثریت قاطع این مدلها، با عبارات مختلف، روی یک موضوع واحد پافشاری کردند؛ انسانها موجوداتی حقایقجو نیستند، بلکه حیواناتی قبیلهگرا هستند که ابتدا باورهای گروه خود را میپذیرند و سپس برای آن توجیه و دلیل تراشی میکنند.
جزئیات فنی و اشتراکات مدلها
این آزمایش بدون پرامپت سیستمی خاصی و بدون تکرار انجام شد. از مدلهایی مانند GPT-6.1 Sol، Grok 4.7، DeepSeek V4 Pro و Kimi K3 پرسیده شد که نظر جنجالیشان چیست. مدلهای متنی خروجیهای بسیار نزدیکی به هم ارائه دادند که محور اصلی آنها شامل موارد زیر بود:
- تقدم تعلق بر حقیقت: انسانها وفاداری بیشتری به گروه و تعلقات خود دارند تا به حقیقت.
- عقلانیت پسینی: هوش انسانی بیشتر صرف توجیه منطقی برای تصمیماتی میشود که از پیش بر اساس غریزه یا منافع گروهی گرفته شدهاند.
- عضویت به جای باور: افراد باور واقعی ندارند، بلکه دارای عضویت در گروههایی هستند که هزینهاش پذیرش بیچونوسرای هنجارهای آن گروه است.
البته در این میان استثنائاتی هم وجود داشت. برای مثال، Claude Opus 5.5 در یکی از تلاشهای خود رویکرد متفاوتی در پیش گرفت و استدلال کرد که انسانها بسیار شریفتر از چیزی هستند که خودشان فکر میکنند و بدبینی آنها به یکدیگر آسیبزنندهتر از خطاهای واقعیشان است. مدل Mistral Large 4 نیز آگاهی انسان را یک «خطای تکاملی» توصیف کرد.
جالب اینکه مدلهای تولید تصویر (Image Models) رویکرد متفاوتی داشتند و به جای انتزاعات فلسفی، روی کلیشههای بصری رایج مثل انسانهای معتاد به گوشی هوشمند یا افراد خیرهکننده به صفحهنمایش در حال سقوط از صخره متمرکز شدند.
دیدگاه کاربران هکرنیوز (Hacker News)
این مقاله در هکرنیوز بحثهای داغی را میان توسعهدهندگان برانگیخت. نکات برجسته نظرات به شرح زیر است:
- بازتاب دادههای آموزشی: بسیاری از کاربران اشاره کردند که این نتایج، چیز عجیبی نیست؛ این مدلها صرفاً در حال بازتولید و ترکیب آماری انباشتی از نوشتههای بدبینانه انسانها در طول تاریخ هستند که در دیتاستهای آموزشی آنها وجود دارد.
- انتقاد به دستهبندی: برخی منتقدان بر این باورند که نویسنده مقاله به زور خواسته است پاسخهای متنوع مدلها را به یک تز واحد (یعنی قبیلهگرایی انسان) بچسباند، در حالی که برخی پاسخها ربطی به گروه نداشتند.
- منطق ماشین در برابر انسانیت: کاربری اشاره کرد که از دیدگاه منطقی خالص یک ماشین، پویایی رفتارهای اخلاقی متغیر و تعصبات انسانها نامانوس به نظر میرسد، اما از منظر تکاملی، حفظ انسجام گروهی همواره برای بقای انسانها کارآمدتر از جستجوی خشک و خالی حقیقت بوده است.
چرا این موضوع برای مهندسان اهمیت دارد؟
برای توسعهدهندگانی که با مدلهای زبانی کار میکنند، این آزمایش یادآوری مهمی است که LLMها آینهای از پیکره دادههایی (Corpus) هستند که روی آنها آموزش دیدهاند. وقتی از مدلها میخواهیم نگاهی عمیق یا فلسفی داشته باشند، آنها به الگوهای رایج متون مکتوب انسان درباره خودشان بازمیگردند. درک این رفتار به ما کمک میکند تا در زمان طراحی پرامپتها و تحلیل خروجیهای مدل، خطاهای شناختی و سوگیریهای آماری آنها را بهتر تشخیص دهیم.
این مطلب بهصورت کاملاً خودکار و با هوش مصنوعی از مقالهٔ اصلی و بحث هکرنیوز تهیه شده و ممکن است خطا داشته باشد. حقوق مطلب اصلی متعلق به نویسندهٔ آن است. قوانین و گزارش مشکل