بررسی خودکار اسناد با ترکیب ابزارهای Unsiloed و TypeSafe Jev — Document Review with Unsiloed and TypeSafe Jev
خلاصه
این مقاله نشان میدهد چگونه میتوان با ترکیب ابزار استخراج داده Unsiloed و مدل تصمیمگیری TypeSafe Jev، خطاهای خوانش OCR و خطاهای منطقی اسناد را شناسایی کرد. این رویکرد به مهندسان کمک میکند تا پipelineهای پردازش اسناد را با هزینه بسیار پایین و دقت بالا مانیتور کنند.
در پردازش اسناد، استخراج درست دادهها توسط ابزارهای OCR به معنای صحت کامل اطلاعات در مراحل بعدی نیست. یک صفر اضافه در یک متن چاپی ممکن است از فیلترهای عالی OCR عبور کند اما در سیستمهای پاییندستی چالشبرانگیز شود. مقاله فنی ارائهشده توسط تیم Unsiloed و TypeSafe روشی ترکیبی برای اعتبارسنجی اسناد و کاهش خطاهای پنهان پیشنهاد میدهد.
معماری راهحل: ترکیب استخراج و تصمیمگیری
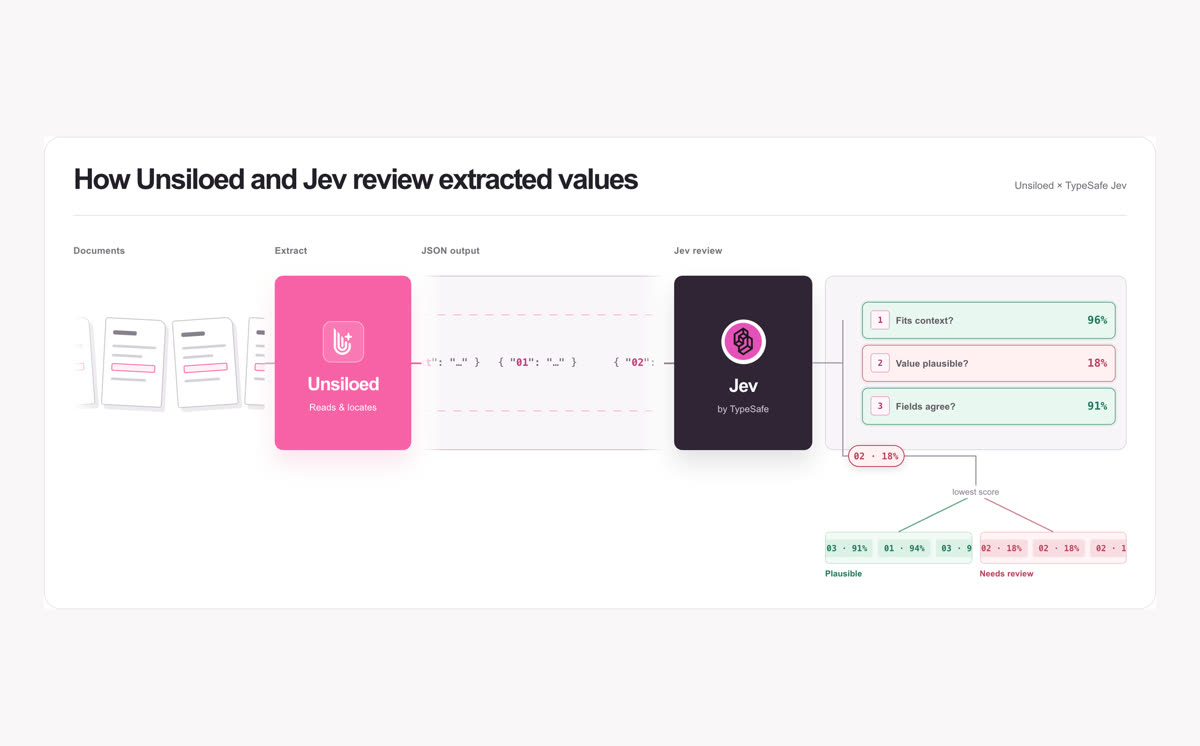
برای حل این مشکل، فرآیند به دو بخش مجزا تقسیم میشود:
- استخراج (Unsiloed): فیلترهای ساختاریافته را استخراج کرده و موقعیت آنها را روی سند مشخص میکند. این ابزار امتیازهای اعتمادی مانند
extraction_scoreوgrounding_scoreبه همراه مختصات (bbox) و شماره صفحه برمیگرداند. - قضاوت و اعتبارسنجی (TypeSafe Jev): مدل Jev اطلاعات استخراجشده را میگیرد و به پرسشهای هدفمند پاسخ میدهد.
نحوه کار با Jev و انواع پاسخها (Types)
در درخواستهای Jev، وضعیت (State) شامل دادههای استخراجشده است و پرسشها (Questions) معیارهای بررسی را تعیین میکنند. مدل Jev از انواع دادهای مشخصی پشتیبانی میکند:
- Noul: احتمال صفر تا یک را برای درستی یک گزاره برمیگرداند (نزدیک به صفر یعنی خیر قاطع و نزدیک به یک یعنی بله قاطع).
- Choice: انتخاب از میان گزینههای نامگذاریشده همراه با توزیع احتمال.
- Score: ارزیابی سطوح مرتبشده یک سنجه.
به عنوان مثال، برای بررسی اینکه آیا دوز دارویی یک نسخه معتبر است یا خیر، میتوان از نوع Noul استفاده کرد. پاسخ این مدل به تنهایی تصویر را نمیبیند و قضاوت خود را بر اساس متن استخراجشده انجام میدهد.
پیادهسازی و منطق مسیریابی بررسی (Review Routing)
سیستم ما باید تصمیم بگیرد که آیا یک ردیف از دادهها نیاز به بازبینی انسانی دارد یا خیر. منطق بررسی بر اساس دو فاکتور اصلی شکل میگیرد:
- پایینترین امتیاز Unsiloed در آن ردیف (برای خطاهای احتمالی خوانش یا لکههای روی سند).
- مقدار عددی Noul از سمت Jev (برای بررسی منطقی بودن مقدار دوز یا فرکانس مصرف).
اگر امتیاز خوانش کمتر از حد آستانه (مثلا 0.90) یا مقدار plausibility کمتر از 0.50 باشد، آن ردیف برای بررسی انسانی پرچمگذاری (Flag) میشود. نکته کلیدی این است که یک پاسخ مثبت از Jev نباید امتیاز پایین OCR را خنثی کند؛ زیرا ممکن است داده کاملاً خوانا باشد اما با یک خطای منطقی چاپی مواجه باشیم.
تحلیل هزینه و بهینهسازی
استفاده از Jev از نظر اقتصادی بسیار مقرونبهصرفه است. به عنوان مثال، پردازش یک لیست دارویی با ۶ سوال و بیش از ۱۸۰۰ توکن ورودی هزینهای بسیار ناچیز (کمتر از یک هزارم دلار به ازای هر سند) اضافه میکند که پردازش ۱۰۰,۰۰۰ سند را کاملاً اقتصادی میسازد.
نگاه جامعه هکر نیوز (Hacker News)
بحثهای پیرامون این مقاله در هکر نیوز نکات جالبی را روشن کرد:
- مثالهای نقض و دادههای پرت: برخی کاربران (مانند rohansood15) به این نکته اشاره کردند که مثال دوز ۱۰ عددی ممکن است یک مثبت کاذب (False Positive) ایجاد کند، زیرا متن دقیقاً همین را گفته است و شاید اعتبارسنجیهای برنامهنویسیشده سنتی به همراه فرایندهای کمکی LLM در برخی سناریوها کارآمدتر باشند.
- تعمیم پipeline: توسعهدهندگان دیگر (مانند armcat) معتقدند این الگو را میتوان به هر سناریوی استخراج داده از جدول، فایل Markdown یا اسناد OCRشده برای اعتبارسنجی سریع On-the-fly تسری داد.
این مطلب بهصورت کاملاً خودکار و با هوش مصنوعی از مقالهٔ اصلی و بحث هکرنیوز تهیه شده و ممکن است خطا داشته باشد. حقوق مطلب اصلی متعلق به نویسندهٔ آن است. قوانین و گزارش مشکل