استقرار مدلهای هوش مصنوعی با تریلیونها پارامتر روی تراشههای ویفری شرکت Cerebras — Cerebras Deploys Trillion-Parameter AI Models
خلاصه
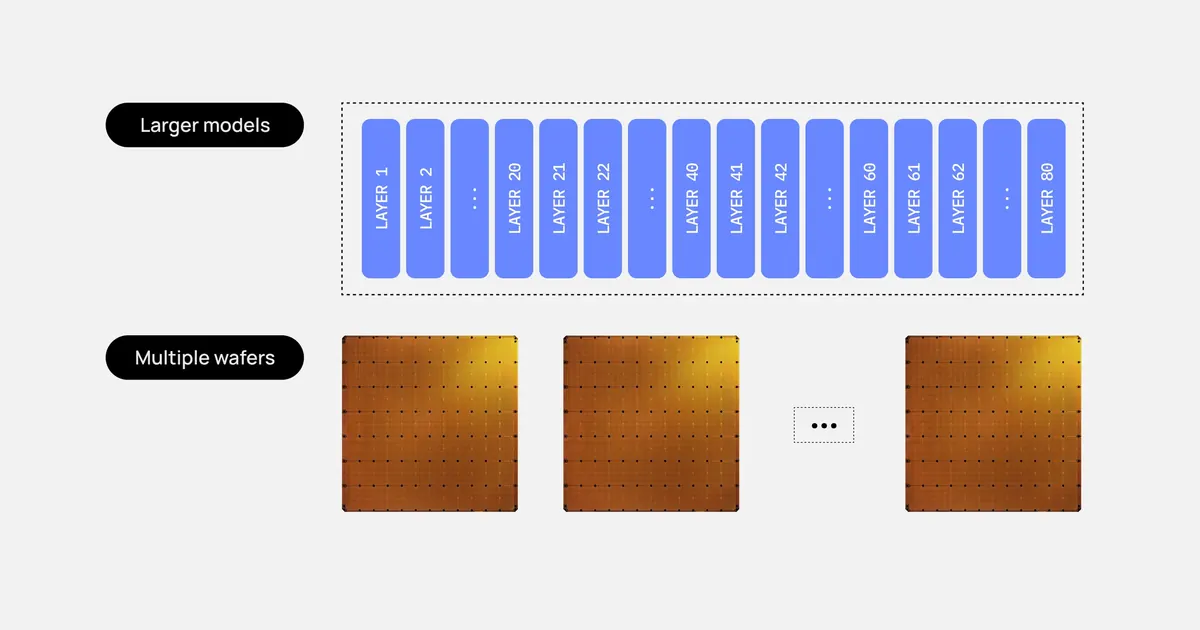
شرکت Cerebras روش خود را برای اجرای مدلهای غولپیکر ۳ تریلیون پارامتری روی تراشههای مقیاس-ویفر (Wafer-scale) تشریح کرد. این معماری با توزیع لایههای مدل روی چندین ویفر و استفاده از پایپلاین پیشرفته، امکان دستیابی به سرعتهای بیسابقهی ۲۰۰۰ توکن بر ثانیه را فراهم میکند.
مقدمه و زمینه
اجرای مدلهای زبانی بزرگ (LLM) با مقیاس تریلیون پارامتری همواره یکی از بزرگترین چالشهای سختافزاری در هوش مصنوعی بوده است. از آنجا که این مدلها به ترابایتها حافظه برای نگهداری وزنهای خود نیاز دارند، سختافزارهای سنتی مانند پردازندههای گرافیکی (GPU) با محدودیتهای حافظه و پهنای باند مواجه میشوند. شرکت Cerebras با ارائهی تراشههای غولپیکر مقیاس-ویفر خود (WSE-3T) رویکرد متفاوتی را در پیش گرفته است. در این مقاله به بررسی نحوهی استقرار مدل متنباز Kimi K3 با ۳ تریلیون پارامتر روی این زیرساخت میپردازیم.
جزئیات فنی استقرار مدلهای تریلیون پارامتری
برای اجرای مدل Kimi K3 که دارای ۶۹ لایهی توجه خطی (Linear-attention) و ۲۴ لایهی متراکم (Dense) است، شرکت Cerebras از مدل کوانتیزاسیون ۴ بیتی برای وزنها استفاده میکند. فرآیند توزیع مدل روی ویفرها شامل مراحل زیر است:
- محاسبه اندازه لایهها: با استفاده از کوانتیزاسیون ۴ بیتی، حجم کل پارامترها تقسیم بر ۹۳ لایه میشود که به معنای نیاز به حدود ۱۶ گیگابایت حافظه برای هر لایه است.
- نقشهبرداری روی ویفرها: هر ترافهی WSE-3T دارای ۴۴ گیگابایت حافظه روی تراشه (SRAM) است. لایههای متراکم به دلیل نیاز به نگهداری KV Cache به ازای هر درخواست، تنها یک لایه در هر ویفر جا میگیرند. در مقابل، لایههای توجه خطی نیازی به KV Cache ندارند و دو لایه در هر ویفر جای میگیرند.
- اتصال ویفرها با پایپلاین: مدل به صورت خطی یا پایپلاین اجرا میشود. وزنهای مدل در جای خود ثابت میمانند و تنها فعالسازیها (Activations) از طریق پروتکل RDMA over Ethernet بین ویفرها منتقل میشوند که تاخیر هر هاب حدود ۲ میکروثانیه است.
مدیریت درخواستها و پردازش موازی
یکی از جنبههای جالب این معماری، نحوهی مدیریت درخواستهای همزمان است. برخلاف دستهبندیهای سنتی GPU که درخواستها باید منتظر اتمام یکدیگر بمانند، پایپلاین Cerebras به صورت پیوسته جریان دارد. هر مرحله از پایپلاین روی یک درخواست یا میکرو-بچ (Micro-batch) متفاوت کار میکند؛ در حالی که مرحلهی سوم روی توکن درخواست A کار میکند، مرحلهی دوم در حال پردازش درخواست B است.
حداکثر تعداد درخواستهای همزمان مستقیماً به فضای باقیمانده در حافظه SRAM ویفرهای لایهی متراکم برای KV Cache بستگی دارد.
دیدگاه جامعه توسعهدهندگان (Hacker News)
در بحثهای انجام شده در Hacker News، کاربران به نکات جالب و گاه چالشبرانگیزی اشاره کردند:
- برخی کاربران از میزان حافظه ۴۴ گیگابایتی ویفرهای غولپیکر شگفتزده شده و آن را نسبت به ابعاد فیزیکی تراشه کم دانستند.
- مباحثی دربارهی نحوهی ارتباط شبکهی دو بعدی هستههای پردازشی (PEها) و جریان دادهها مطرح شد.
- برخی توسعهدهندگان معتقدند دستیابی به سرعتهای بسیار بالا (مانند ۱۰۰۰ تا ۲۰۰۰ توکن بر ثانیه) میتواند رابطهی ما با ابزارهای هوش مصنوعی و زمان پاسخگویی را کاملاً دگرگون کند.
چرا این موضوع برای مهندسان اهمیت دارد؟
این معماری نشان میدهد که چگونه میتوان با ترکیب حافظه بسیار سریع SRAM روی تراشه و معماری پایپلاین بهینهسازیشده، گلوگاههای مرسوم حافظه رم (مثل سرعت انتقال HBM در GPUها) را دور زد. دستابی به سرعتهای تولید توکن در مقیاس هزاران توکن بر ثانیه، درگاه جدیدی را برای کاربردهای زمانواقعی (Real-time) و مدلهای عاملمحور (Agentic) باز میکند.
این مطلب بهصورت کاملاً خودکار و با هوش مصنوعی از مقالهٔ اصلی و بحث هکرنیوز تهیه شده و ممکن است خطا داشته باشد. حقوق مطلب اصلی متعلق به نویسندهٔ آن است. قوانین و گزارش مشکل