تبدیل گفتار به متن با سرعت خیرهکننده روی مکبوک؛ استفاده از EmbeddingGemma 2 گوگل به روشی نوآورانه — We turned EmbeddingGemma 2 into a speech-to-text model
خلاصه
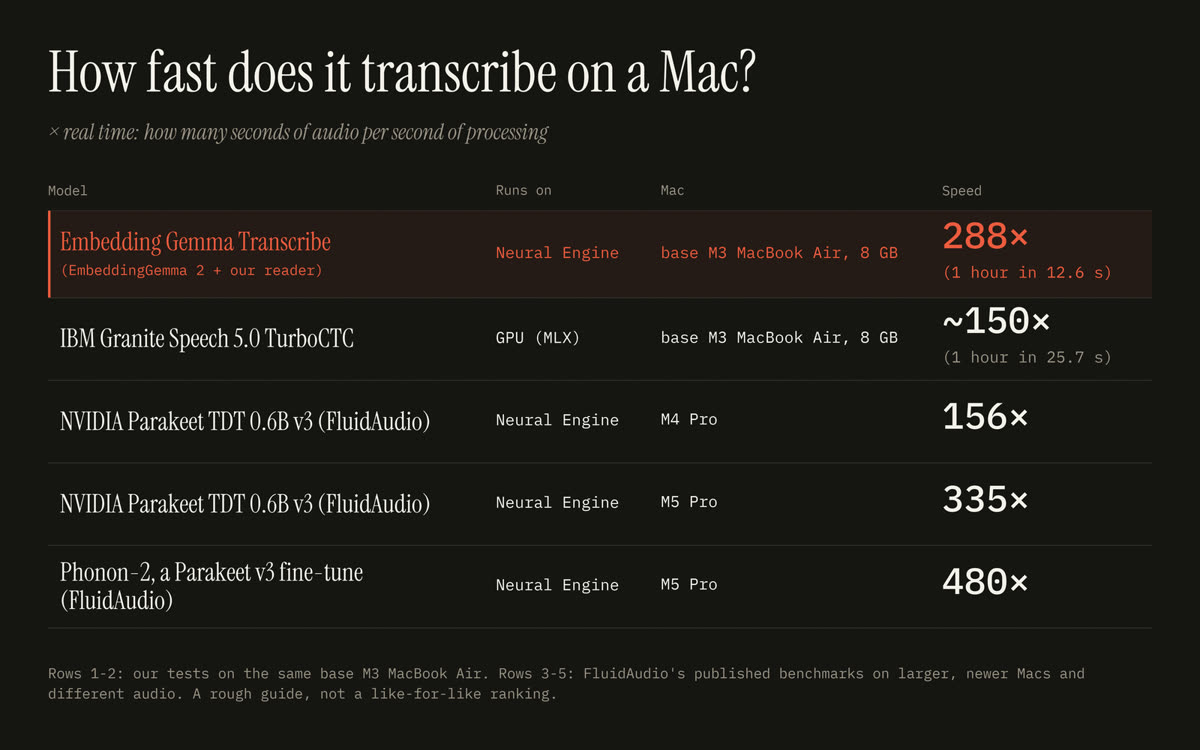
توسعهدهندگان با استفاده از فضای برداری مشترک مدل EmbeddingGemma 2 توانستند آن را به یک ابزار تبدیل گفتار به متن محلی تبدیل کنند. این سیستم قادر است یک ساعت صوت را تنها در ۱۳ ثانیه روی مکبوک ایر و بهصورت کاملاً آفلاین پردازش کند.
معرفی پروژه و زمینه
مدلهای چندوجهی مدرن معمولاً دادههای متنی، تصویری و صوتی را در یک فضای برداری مشترک پردازش میکنند. در این آزمایش جذاب که توسط Shiraz (Shahir) انجام شده و بازخورد بالایی در Hacker News دریافت کرده است، مدل EmbeddingGemma 2 گوگل که ذاتاً برای وظایف دیگری طراحی شده بود، به عنوان یک موتور تبدیل گفتار به متن (Speech-to-Text) مورد استفاده قرار گرفت. ایده اصلی این است که اگر صوت و متن در یک فضای مشترک معنایی قرار داشته باشند، میتوان با خواندن مستقیم کلمات از آن فضا، صوت را به متن تبدیل کرد.
جزئیات فنی و نحوه کارکرد
نکته جالب اینجاست که مدل اصلی EmbeddingGemma 2 بدون هیچگونه تغییر یا بازآموزی در بخش انکودر صوتی (Audio Encoder) استفاده شده است. معماری و مکانیسم این روش به شرح زیر است:
- انکودر صوتی مدل دستنخورده باقی مانده است.
- یک لایه خوانشگر (Reader) کوچک، تکههای کوتاه صوتی را به فضای متنی مدل منتقل میکند.
- از میان حدود ۲۲۹ هزار کلمه انگلیسی، نزدیکترین کلمه برنده میشود و این تکهها به متن نهایی تبدیل میشوند.
- یک مدل کوچک کمکی نیز مسئولیت افزودن علائم نگارشی و حروف بزرگ را بر عهده دارد.
تنها بخشی که نیاز به آموزش داشته، همان لایه خوانشگر است که در کمتر از دو ساعت روی ۸ کارت گرافیک H100 و با استفاده از دادههای گفتاری انگلیسی متنباز آموزش دیده است. سرعت پردازش به حدی بالاست که یک ساعت فایل صوتی تنها در حدود ۱۳ ثانیه روی یک دستگاه پایه MacBook Air پردازش میشود و کل عملیات روی سختافزار دستگاه و با استفاده از Neural Engine اجرا میگردد تا حریم خصوصی کاربر حفظ شود.
وضعیت فعلی و مقایسه
در حال حاضر، نرخ خطای کلمه (WER) این مدل حدود ۵ درصد است، در حالی که مدلهای پیشرفته ابری خطایی در حدود ۲ تا ۳ درصد دارند. با این حال، سازنده معتقد است که با آموزش بیشتر روی دادههای متنوعتر، میتوان این فاصله را به حداقل رساند. سرعت بالا در این پروژه یک هدف اولیه نبوده، بلکه دستاوردی جانبی از ساختار مدل بوده است.
دیدگاه جامعه مهندسی در Hacker News
در بحثهای هکرنیوز، کاربران از پیشرفت فوقالعاده ابزارهای محلی شگفتزده شده بودند. بسیاری به این نکته اشاره کردند که تفاوت سرعت و کیفیت ابزارهای تبدیل گفتار محلی (مانند ابزارهای مبتنی بر Whisper یا Parakeet) نسبت به چند سال گذشته متحول شده است. برخی کاربران درباره انتشار کد منبع (Open Source) پرسش داشتند و سازنده اعلام کرد که کدهای پروژه بهزودی منتشر خواهد شد.
این مطلب بهصورت کاملاً خودکار و با هوش مصنوعی از مقالهٔ اصلی و بحث هکرنیوز تهیه شده و ممکن است خطا داشته باشد. حقوق مطلب اصلی متعلق به نویسندهٔ آن است. قوانین و گزارش مشکل