برنامهنویسی با سرعت نور: ساخت موتور پرسوجوی Gravity برای pgrust — Programming at Light Speed: Building the Gravity Query Engine
خلاصه
توسعهدهندگان pgrust با انتشار نسخهی v0.4-beta موتور پرسوجوی Gravity را معرفی کردند که با استفاده از کامپایل در لحظه (JIT) و رویکرد طراحی از بالا به پایین، توانسته است در بنچمارک ClickBench حتی از ClickHouse هم سریعتر عمل کند. این موتور تمام دیالکت و سیستم تایپ Postgres را پشتیبانی میکند.
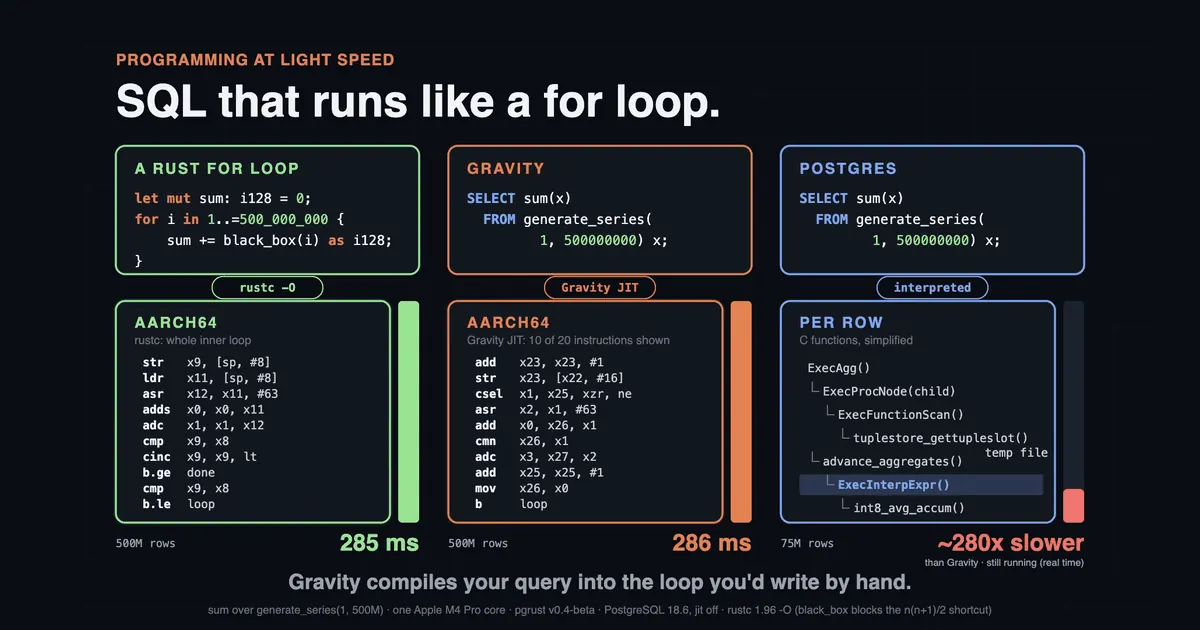
تیم توسعهپروژه pgrust با انتشار نسخه v0.4-beta از موتور پرسوجوی جدید خود به نام Gravity رونمایی کردهاند. این موتور توانسته است در بنچمارک معروف ClickBench (که توسط خود تیم ClickHouse برای نشان دادن سرعت بالای این دیتابیس طراحی شده بود) تا سه برابر سریعتر از ClickHouse ظاهر شود. نکتهی شگفتانگیز این است که Gravity این سرعت فوقالعاده را در حالی ارائه میدهد که از کل دستور زبان (Dialect) و سیستم تایپ Postgres پشتیبانی کامل میکند.
پسزمینه و مسیر طیشده
در نسخههای قبلی، تیم سازنده با استفاده از روشهایی مانند دستهبندی دادهها (Batching)، ادغام عملگرها (Operator Fusion) و دستورات SIMD توانسته بود سرعت اجرای پرسوجوهای تحلیلی را نسبت به Postgres صدها برابر افزایش دهد. آنها همچنین یک کامپایلر JIT از نوع copy-and-patch ساخته بودند که استنسیلها را در ۵ میکروثانیه کامپایل میکرد.
با این حال، رویکرد کپی و پیوند دادن قالبهای از پیش کامپایلشده محدودیتهایی داشت؛ زیرا فاقد یک نمای میانی (IR) واقعی یا تخصیص رجیستر در کل حلقههای پردازشی بود و در مقایسه با کامپایلرهای بهینهسازی مانند rustc یا Clang عملکرد بهینهای ارائه نمیداد. به همین دلیل، برای نسخه v0.4 تصمیم گرفته شد یک کامپایلر پرسوجوی کامل ساخته شود که کُد ماشینی بهینه برای هر دستور SQL تولید کند.
رویکرد «برنامهنویسی با سرعت نور»
به جای بهینهسازی تدریجی پایین به بالا (Bottom-Up) که معمولاً مهندسان برای افزایش سرعت نرمافزار استفاده میکنند، تیم سازنده پرسش را برعکس کرد: یک دیتابیس واقعاً چقدر میتواند سریع باشد؟
برای کشف این حد نهایی یا همان «سرعت نور»، آنها از هوش مصنوعی (Claude) استفاده کردند تا برنامههای مستقل و بسیار بهینهی Rust را مستقیماً روی کریتهای ذخیرهسازی ستونی (Columnar Storage) برای مجموعهای از پرسوجوها بنویسد. این برنامههای دستی بدون نیاز به مفسر SQL، حلقههای چندرشتهای Rust به همراه SIMD را مستقیماً روی فایلهای دیسک اجرا میکردند. این کدهای دستنویس حدود ۴ برابر سریعتر از دیتابیسهای تحلیلی موجود مانند ClickHouse اجرا شدند. هدف Gravity این شد که برای هر پرسوجو، کُد ماشینی در زمان اجرا (JIT) تولید کند که تنها ۲۰ درصد با آن کدهای دستنویس فاصله داشته باشد.
معماری و پایپلاین کامپایلر Gravity
موتور Gravity به عنوان یک پایپلاین چندمرحلهای طراحی شده است که برنامهی سطوح بالای Postgres را به زبان اسمبلی تبدیل میکند:
SQL Query -> Postgres Plan -> Pipeline Graph -> Lisp IR -> Assembly
مراحل اصلی این معماری عبارتند از:
- طرح Postgres: برنامه استاندارد
Postgresبا تحلیل آمارهای جدول تولید میشود. - گراف پایپلاین (Pipeline Graph): طرح پرسوجو به گراف پایپلاین تبدیل میشود تا جریان دادهها را مدیریت کند (مانند اسکن، فیلتر، پروژکشن و تجمیع).
- نمای میانی Lisp IR: هر پایپلاین به یک تابع واحد در قالب نمای میانی الهامگرفته از
Lispکامپایل میشود. - کُد اسمبلی (Assembly): در نهایت، بکاندها نمای میانی
IRرا به کُد ماشین و اسمبلی تبدیل میکنند.
چرا این موضوع برای مهندسان اهمیت دارد؟
این پروژه نشان میدهد که چگونه میتوان با ترکیب مهندسی کامپایلر، معماری دیتابیسهای ستونی و ابزارهای هوش مصنوعی به عنوان دستیار بهینهسازی، محدودیتهای سنتی پایگاههای داده را کنار زد. کاربران در بحثهای Hacker News از ساختار تمیز این پروژه و روش هوشمندانهی بررسی کدهای تولید شده توسط هوش مصنوعی تمجید کردهاند.
این مطلب بهصورت کاملاً خودکار و با هوش مصنوعی از مقالهٔ اصلی و بحث هکرنیوز تهیه شده و ممکن است خطا داشته باشد. حقوق مطلب اصلی متعلق به نویسندهٔ آن است. قوانین و گزارش مشکل