چگونه قابلیت recovery_prefetch در PostgreSQL میتواند باعث قطعی ناخواسته در پروداکشن شود؟ — Postgres recovery_prefetch can cause outages
خلاصه
مقاله بررسی میکند که چگونه قابلیت recovery_prefetch در پستگرس با ایجاد تقاضای شدید I/O و تقویت IOPS روی دیتابیسهای استندبای، در ترکیب با replication سنکرون، میتواند منجر به قطعیهای طولانیمدت در محیط پروداکشن شود. خاموش کردن این قابلیت میتواند راهحل موقتی برای این مشکل باشد.
مقدمه
مدیریت پایداری و عملکرد دیتابیسها در مقیاسهای بزرگ همواره چالشبرانگیز است. در دنیای پایگاههای داده، PostgreSQL به عنوان یکی از محبوبترین گزینههای متنباز شناخته میشود که مهندسان نرمافزار به خاطر قابلیت اطمینان بالا به آن اعتماد میکنند. با این حال، گاهی اوقات ویژگیهایی که برای بهبود عملکرد طراحی شدهاند، در شرایط خاص نتایج معکوس و خطرناکی به همراه دارند. مقاله اخیر درباره ویژگی recovery_prefetch نشان میدهد که چگونه یک بهینهسازی ظاهراً بیخطر میتواند به قطعیهای جدی در سیستمهای پروداکشن منجر شود.
پسزمینه و مفهوم recovery_prefetch
برای درک ریشهای این مشکل، باید نگاهی به نحوه کارکرد ریکاوری و تکرار دادهها (Replication) در پستگرس بیندازیم. در نسخههای مدرن PostgreSQL، قابلیت recovery_prefetch معرفی شد تا روند خواندن بلوکها از دیسک را پیش از اعمال تغییرات لاگ (WAL) تسریع کند. ایده اصلی این بود که با پیشبینی نیازهای خواندن، کارهای مربوط به ریکاوری سریعتر انجام شوند.
اما دو واقعیت فنی مهم در اکثر زیرساختهای امروزی وجود دارد:
- استفاده همهسنخ از FPI/FPW: برای جلوگیری از خراب شدن دادهها (Torn Writes) هنگام ریاستارت سیستم، پستگرس از Full Page Images استفاده میکند. این یعنی بخش عمدهای از بلوکهای مورد نیاز از قبل درون خود دادههای WAL وجود دارند و نیازی به خواندن مجدد از دیسک نیست.
- رواج replication سنکرون: برای تضمین عدم از دست رفتن دادهها (Durability)، بسیاری از تیمها از حالت سنکرون استفاده میکنند که در آن سرور اصلی برای تأیید تراکنشها به پاسخ سرور استندبای وابسته است.
مکانیسم بروز مشکل و تقویت IOPS
مشکل اصلی اینجاست که recovery_prefetch تفاوت میان دادههایی که از طریق FPI بارگذاری میشوند و دادههایی که واقعاً باید از دیسک خوانده شوند را به درستی تفکیک نمیکند. هنگامی که سرور اصلی عملیات سنگین I/O ترتیبی (Sequential I/O) انجام میدهد، قابلیت recovery_prefetch در سرور استندبای این عملیات را به خواندنهای تصادفی ۸ کیلوبایتی (Random Reads) تبدیل میکند.
این فرآیند باعث تقویت حجم IOPS تا ۱۶ برابر در سرورهای استندبای میشود. در سرورهای ابری یا سختافزارهایی که محدودیت IOPS دارند، این پدیده به سرعت منابع دیسک را اشغال کرده و استندبای را به شدت عقب میاندازد (Lag).
ترکیب مرگبار با Replication سنکرون
چرا این موضوع به قطعی (Outage) منجر میشود؟ به این دلیل که معماری replication سنکرون در پستگرس به شدت وابسته به سلامت ارتباط و همگامسازی است. ماشین حالت ریکاوری در پستگرس (WaitForWALToBecomeAvailable) به گونهای طراحی شده است که اگر استندبای عقب بماند، برای رسیدن به سرور اصلی تلاش میکند و تا زمانی که کاملاً همگام نشود، به حالت استریمینگ عادی برنمیگردد.
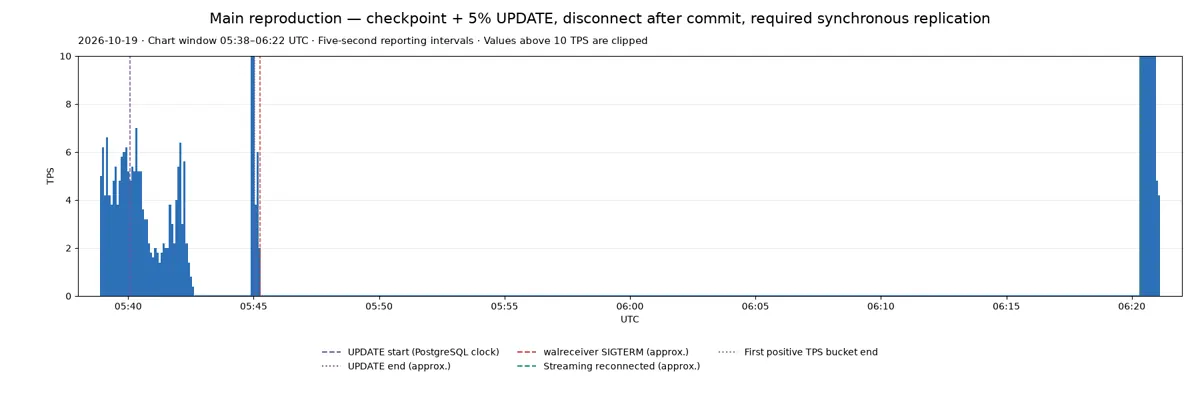
اگر یک اختلال کوچک شبکه رخ دهد و همزمان یک انفجار از عملیات نوشتن (Write Burst) در سیستم اتفاق بیفتد، ترکیب زیر رخ میدهد:
- سرور استندبای به خاطر IOPS بالا کند میشود.
- اتصال walreceiver قطع میشود.
- سرور اصلی به دلیل سنکرون بودن، نوشتنها را متوقف کرده و منتظر استندبای میماند.
- استندبای به دلیل حجم بالای کارهای عقبافتاده و رفتارهای
recovery_prefetchساعتها در حالت ریکاوری گیر میکند.
چرا این مسئله برای مهندسان اهمیت دارد؟
این مسئله نشان میدهد که تنظیمات پیشفرض دیتابیس همیشه برای تمام سناریوهای پروداکشن بهینه نیستند. این موضوع به راحتی در محیطهای تستی با سختافزارهای محدود قابل بازآفرینی است. نویسنده مقاله پیشنهاد میکند که تا زمان بررسی دقیقتر توسط توسعهدهندگان هسته پستگرس، مهندسان باید غیرفعال کردن recovery_prefetch را در پوستههای پروداکشن خود زیر نظر داشته باشند، بهویژه اگر با مشکلاتی نظیر تأخیر عجیب استندبای مواجه هستند.
علاوه بر این، استفاده از روشهای جایگزین مانند Quorum Commit (پیکربندی ANY 1 با چند استندبای به جای یک استندبای) میتواند پایداری کلی معماری دیتابیس را در برابر چنین حوادثی افزایش دهد.
این مطلب بهصورت کاملاً خودکار و با هوش مصنوعی از مقالهٔ اصلی و بحث هکرنیوز تهیه شده و ممکن است خطا داشته باشد. حقوق مطلب اصلی متعلق به نویسندهٔ آن است. قوانین و گزارش مشکل