کاهش حجم فایلهای MMDB تا یکسوم بدون تغییر حتی یک بایت داده — How we made our MMDB files a 33% smaller
خلاصه
تیم IPinfo روشی مبتنی بر تکنیک Hash-Consing برای فشردهسازی ساختار درخت جستجو در فایلهای MMDB ارائه داده است که حجم پایگاه دادههای آیپی را بهطور چشمگیری کاهش میدهد. این بهینهسازی بدون نیاز به تغییر فرمت یا کتابخانههای خواندن، باعث کاهش مصرف حافظه و بهبود سرعت میشود.
فرمت فایل MMDB یکی از ساختارهای رایج برای ذخیرهسازی و جستجوی سریع متادیتای آدرسهای آیپی (مانند کشور، شهر و اطلاعات ASN) است. این فرمت که بهطور گسترده در مهندسی نرمافزار و ابزارهای امنیتی استفاده میشود، مبتنی بر نگاشت حافظه (Memory-Mapped) است؛ به این معنا که اندازه فایل مستقیماً ردپای حافظه رم (Memory Footprint) آن را تعیین میکند.
تیم IPinfo اخیراً متوجه شد که ساختار این فایلها دارای افزونگی قابلتوجهی است و ابزارهای استاندارد تولیدکننده این فایلها، گرههای تکراری زیادی ایجاد میکنند. آنها برای حل این مشکل ابزاری متنباز به نام mmdbshrink (بخشی از پروژه mmdbctl) توسعه دادهاند که حجم فایلهای MMDB را بدون تغییر دادهها تا حدود یکسوم کاهش میدهد.
ساختار فایلهای MMDB و مشکل افزونگی
فایلهای MMDB از دو بخش اصلی تشکیل شدهاند:
- بخش جستجو (Search Tree): یک درخت دودویی (Binary Trie) بر اساس بیتهای آدرس آیپی که با خواندن بیتبهبیت آدرس، مسیر حرکت را تعیین میکند.
- بخش داده (Data Section): جایی که رکوردهای نهایی مانند موقعیت مکانی یا پرچمهای حریم خصوصی ذخیره میشوند.
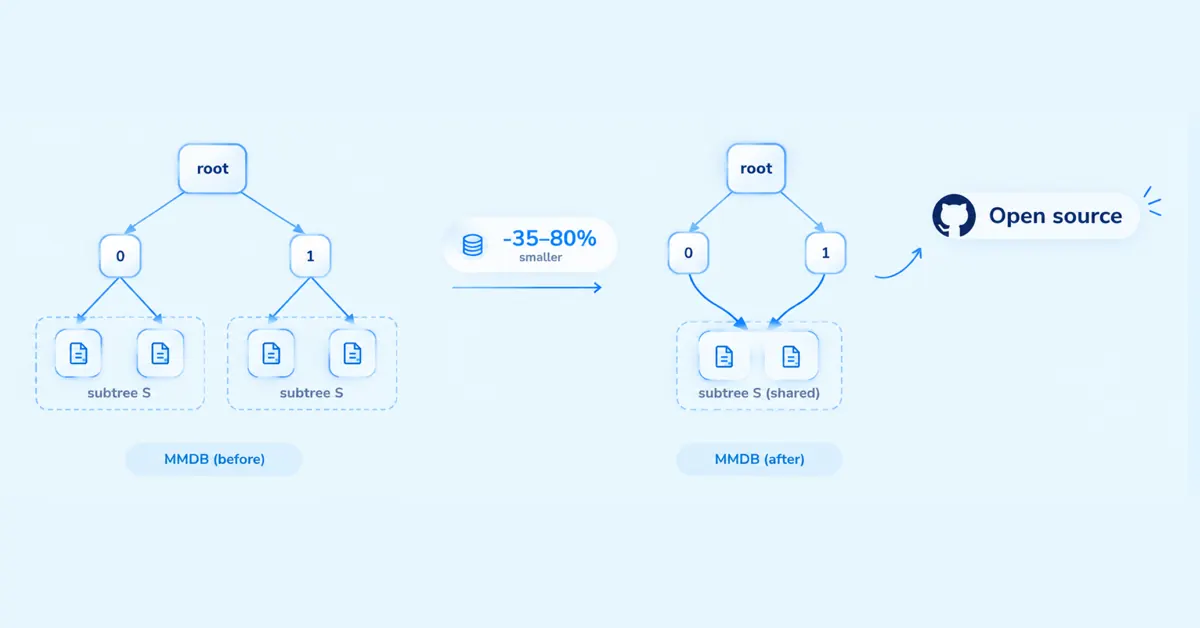
بخش داده از مدتها پیش بهینهسازی شده بود و از پترنهای ارجاعدهی برای رکوردهای تکراری پشتیبانی میکرد. اما در بخش درخت جستجو، نویسندههای استاندارد فایل، برای هر موقعیت یک گره کاملاً تازه میساختند؛ حتی اگر زیردرختهای دو پیشوند مختلف در شبکه دقیقاً بیتبهبیت با هم یکسان بودند. با توجه به ماهیت تکرارپذیر اینترنت، حجم عظیمی از گرهها در این درختها در واقع کپیهای تکراری از یکدیگر بودند.
ایده فنی: استفاده از تکنیک Hash-Consing
برای حذف این گرههای تکراری، مهندسان IPinfo از تکنیک قدیمی و اثباتشدهی Hash-Consing (که در کامپایلرها و محاسبات نمادین کاربرد دارد) استفاده کردند. این روش شامل مراحل زیر است:
- پیمایش درخت موجود از سمت برگها به سمت ریشه (Bottom-Up).
- استفاده از یک جدول هش (Hash Table) برای نگهداری گرههای ساخته شده.
- بررسی جفت گرههای فرزند؛ اگر جفت مشابهی از قبل در جدول موجود باشد، به جای ساخت گره جدید، از گره کاننیکال قبلی استفاده میشود.
- در نتیجه، ساختار درخت به یک گراف غیرمدور جهتدار (DAG) تبدیل میشود که چندین والد میتوانند به یک زیردرخت مشترک اشاره کنند.
این تغییر ساختار هیچ تغییری در فرمت فایل MMDB ایجاد نمیکند. تمامی کتابخانهها و SDKهای موجود بدون نیاز به آپدیت، قادر به خواندن فایلهای بهینهشده خواهند بود.
نتایج و دستاوردهای مهندسی
اجرای این ابزار روی مجموعهدادههای تولیدی نتایج چشمگیری به همراه داشت:
- کاهش حجم کلی: کاتالوگ پایگاه دادههای IPinfo از ۹۱.۲ گیگابایت به ۶۲.۸ گیگابایت (کاهش ۳۱ درصدی) رسید و برخی فایلها مانند پایگاه داده حریم خصوصی تا ۸۰ درصد کوچکتر شدند.
- کاهش مصرف حافظه: از آنجا که فایلهای MMDB به صورت mmap بارگذاری میشوند، کاهش حجم فایل مستقیماً به کاهش مصرف حافظه رم (Resident Memory) منجر شد.
- عملکرد بدون افت سرعت: سرعت جستجو تغییری نکرد و حتی به دلیل کاهش خطاهای صفحه (Page Faults) در حافظه، در برخی بنچمارکها بهبود جزئی داشت.
در بحثهای هکرنیوز (Hacker News)، مهندسان به پتانسیل بالای این بهینهسازی در سیستمهای توزیعشده اشاره کرده و مطرح کردند که کاهش بیشتر تعداد گرهها حتی میتواند بهینهسازیهای بیشتری در اندازه فیلدهای رکورد ایجاد کند.
ابزار mmdbshrink تحت مجوز Apache 2.0 به صورت متنباز منتشر شده و با دستور ساده go install قابل نصب است. اگر خودتان فایلهای MMDB تولید میکنید، اجرای این ابزار میتواند حجم فایلهای شما را بهطور چشمگیری کاهش دهد.
این مطلب بهصورت کاملاً خودکار و با هوش مصنوعی از مقالهٔ اصلی و بحث هکرنیوز تهیه شده و ممکن است خطا داشته باشد. حقوق مطلب اصلی متعلق به نویسندهٔ آن است. قوانین و گزارش مشکل