کالبدشکافی یک صفحه: نگاهی به الگوریتمهای پیچیده تایپوگرافی در پشت صحنه — A page looks innocent: the algorithms behind a typeset page
خلاصه
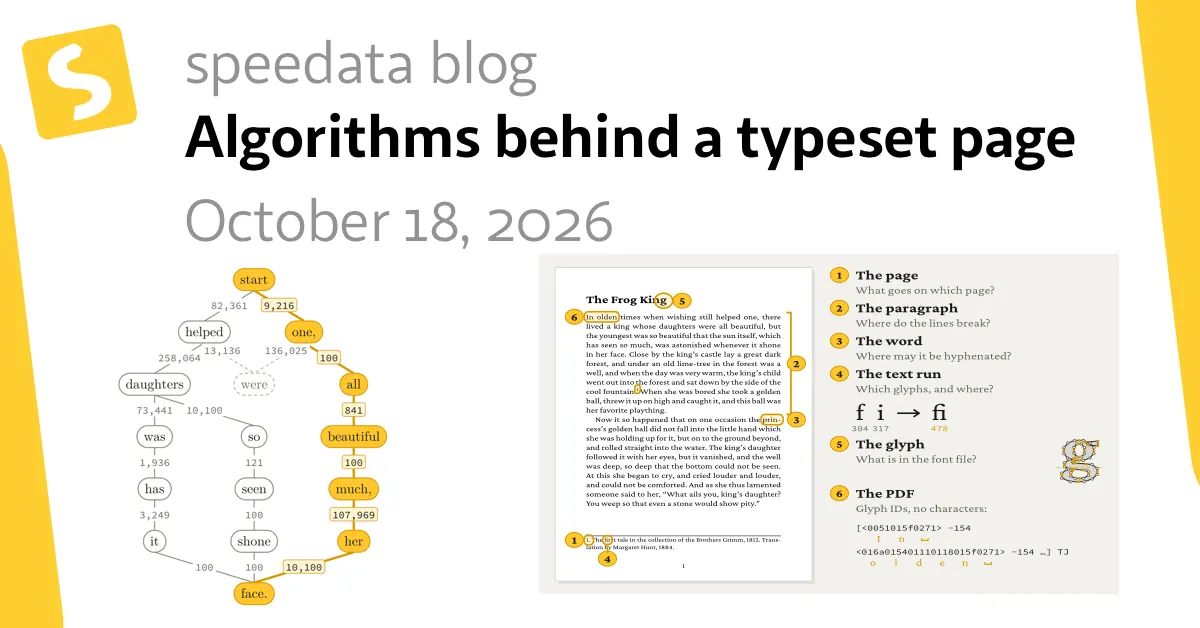
این مقاله به بررسی لایههای مختلف پردازش متن میپردازد؛ از مدیریت صفحات و پاراگرافها گرفته تا موتورهای شکلدهی فونت و فایل نهایی PDF. این مبحث برای مهندسان نرمافزار جذاب است زیرا چالشهای پیچیده الگوریتمیِ تبدیل کاراکترهای یونیکد به یک سند چاپی استاندارد را بازگو میکند.
مقدمه
وقتی به صفحه یک کتاب یا کاتالوگ باکیفیت نگاه میکنیم، همایشی از متن، جدول، تصویر و پانویس را میبینیم که بسیار ساده به نظر میرسد. اما تکتک سطرهای این صفحه حاصل تصمیمگیریهای پیچیده الگوریتمی هستند که ریشه برخی از آنها به دههها پیش بازمیگردد. در این مقاله نگاهی به آناتومی یک صفحه انداخته شده و از بالاترین سطح (کل صفحه) تا پایینترین سطح (بایتهای فایل PDF) موشکافی میشود.
این بررسی بر اساس دو ابزار انجام گرفته است: speedata Publisher که در پسزمینه از LuaTeX بهره میبرد، و کتابخانه boxes and glue که یک پیادهسازی مدرن به زبان Go است.
۱. صفحه و چالشهای کلان
نخستین و بزرگترین مسئله این است که چه چیزی باید روی کدام صفحه قرار بگیرد. برخلاف ساختار سنتی TeX، ابزارهایی مانند Publisher دارای مدل صفحهبندی اختصاصی با شبکهها و مناطق مشخص هستند. در این سطح با مشکلاتی نظیر موارد زیر روبهرو هستیم:
- یتیم و بیوه (Widows and Orphans): تنها ماندن یک سطر از پاراگراف در بالا یا پایین صفحه.
- جداول چندصفحهای: شکستن جدول در میان سطرها همراه با تکرار هدر در صفحه بعد.
- پانویسها: مدیریت فضای اشغالشده توسط پانویس که میتواند رفرنس مربوطه را به صفحه بعد منتقل کند.
۲. پاراگراف و شکستن سطرها
واژهپردازهای معمولی سطرها را یکییکی پر میکنند که باعث ایجاد فضاهای خالی بزرگ بین کلمات میشود. اما الگوریتم کلاسیک Donald Knuth و Michael Plass کل پاراگراف را به صورت یکجا بررسی میکند. این الگوریتم به کمک گرافها، تمام نقاط شکست ممکن را ارزیابی کرده و مسیری را با کمترین هزینه یا جریمه (Demerits) انتخاب میکند تا فاصله کلمات در کل پاراگراف متوازن بماند.
علاوه بر این، تکنیکهایی مانند Font Expansion (تغییر عرض ملایم گلیفها) و Hanging Punctuation (بیرونزدگی علائم نگارشی از حاشیه) به بهبود ظاهر کار کمک میکنند.
۳. واژهها و خطتیره (Hyphenation)
ذخیره تمام کلمات یک زبان در فرهنگ لغت غیرپراکتیک است. از این رو TeX از الگوهای ابداعشده توسط Frank Liang استفاده میکند. الگوهای عددی مشخص میکنند که کجا میتوان یک کلمه را با خطتیره شکست. اعداد فرد اجازه شکست و اعداد زوج آن را منع میکنند و در نهایت بالاترین عدد تصمیم نهایی را میگیرد.
۴. موتور شکلدهی (Shaping) و کاراکتر به گلیف
متن ورودی دنبالهای از کاراکترهای یونیکد است، اما PDF حاوی اشکال یا همان گلیفهاست. تبدیل کاراکتر به گلیف تنها یک جستجوی ساده نیست و شامل موارد زیر میشود:
- لیگاتورها (مانند ترکیب
fi) - کرنینگ (تنظیم فاصله زوج حروف مثل
AV) - اشکال متوالی در زبانهایی مانند عربی
- جهت متن در زبانهای راستبهچراغ (Bidi)
کتابخانه HarfBuzz مرجع اصلی این کار است و نسخهای از آن نیز به زبان Go برای کتابخانه boxes and glue پورت شده است.
۵. گلیف و فایل PDF نهایی
در پایینترین سطح، فونتهای OpenType مانند پایگاههای دادهای کوچک عمل میکنند که نقشههای کاراکتر (cmap)، ابعاد (hmtx) و خطوط را در خود دارند. در فایل نهایی PDF، متن به صورت شناسههای گلیف ذخیره میشود و مختصات قرارگیری هر کاراکتر با دقت بالا تعیین میگردد. این ساختار توضیح میدهد که چرا گاهی کپی کردن متن از برخی PDFها خروجی نامطلوبی تولید میکند.
نگاه جامعه مهندسی (Hacker News)
در بحثهای انجامشده پیرامون این موضوع، کاربران اشاره کردند که اگرچه این مباحث جذاب و بصری هستند، اما فرآیندهای مشابه پردازش متن امروزه در سطح سیستمعاملها و اپلیکیشنهای موبایل نیز به صورت لحظهای در حال اجراست و محدود به چاپ کتاب یا کاتالوگ نیست.
این مطلب بهصورت کاملاً خودکار و با هوش مصنوعی از مقالهٔ اصلی و بحث هکرنیوز تهیه شده و ممکن است خطا داشته باشد. حقوق مطلب اصلی متعلق به نویسندهٔ آن است. قوانین و گزارش مشکل